
 搜索

一家公司如果要从头训练一个工业AI大模型,首先要做的可能不是建模,而是等待——等产线故障发生、等缺陷上报、等数据回流,也许一个月,也许一年。没有真实产线数据的工业AI大模型,如同修筑于流沙之上。数据匮乏,长期以来都是这个行业难以逾越的堑壕。
如今,这一痛点可以通过拍几张照片解决。
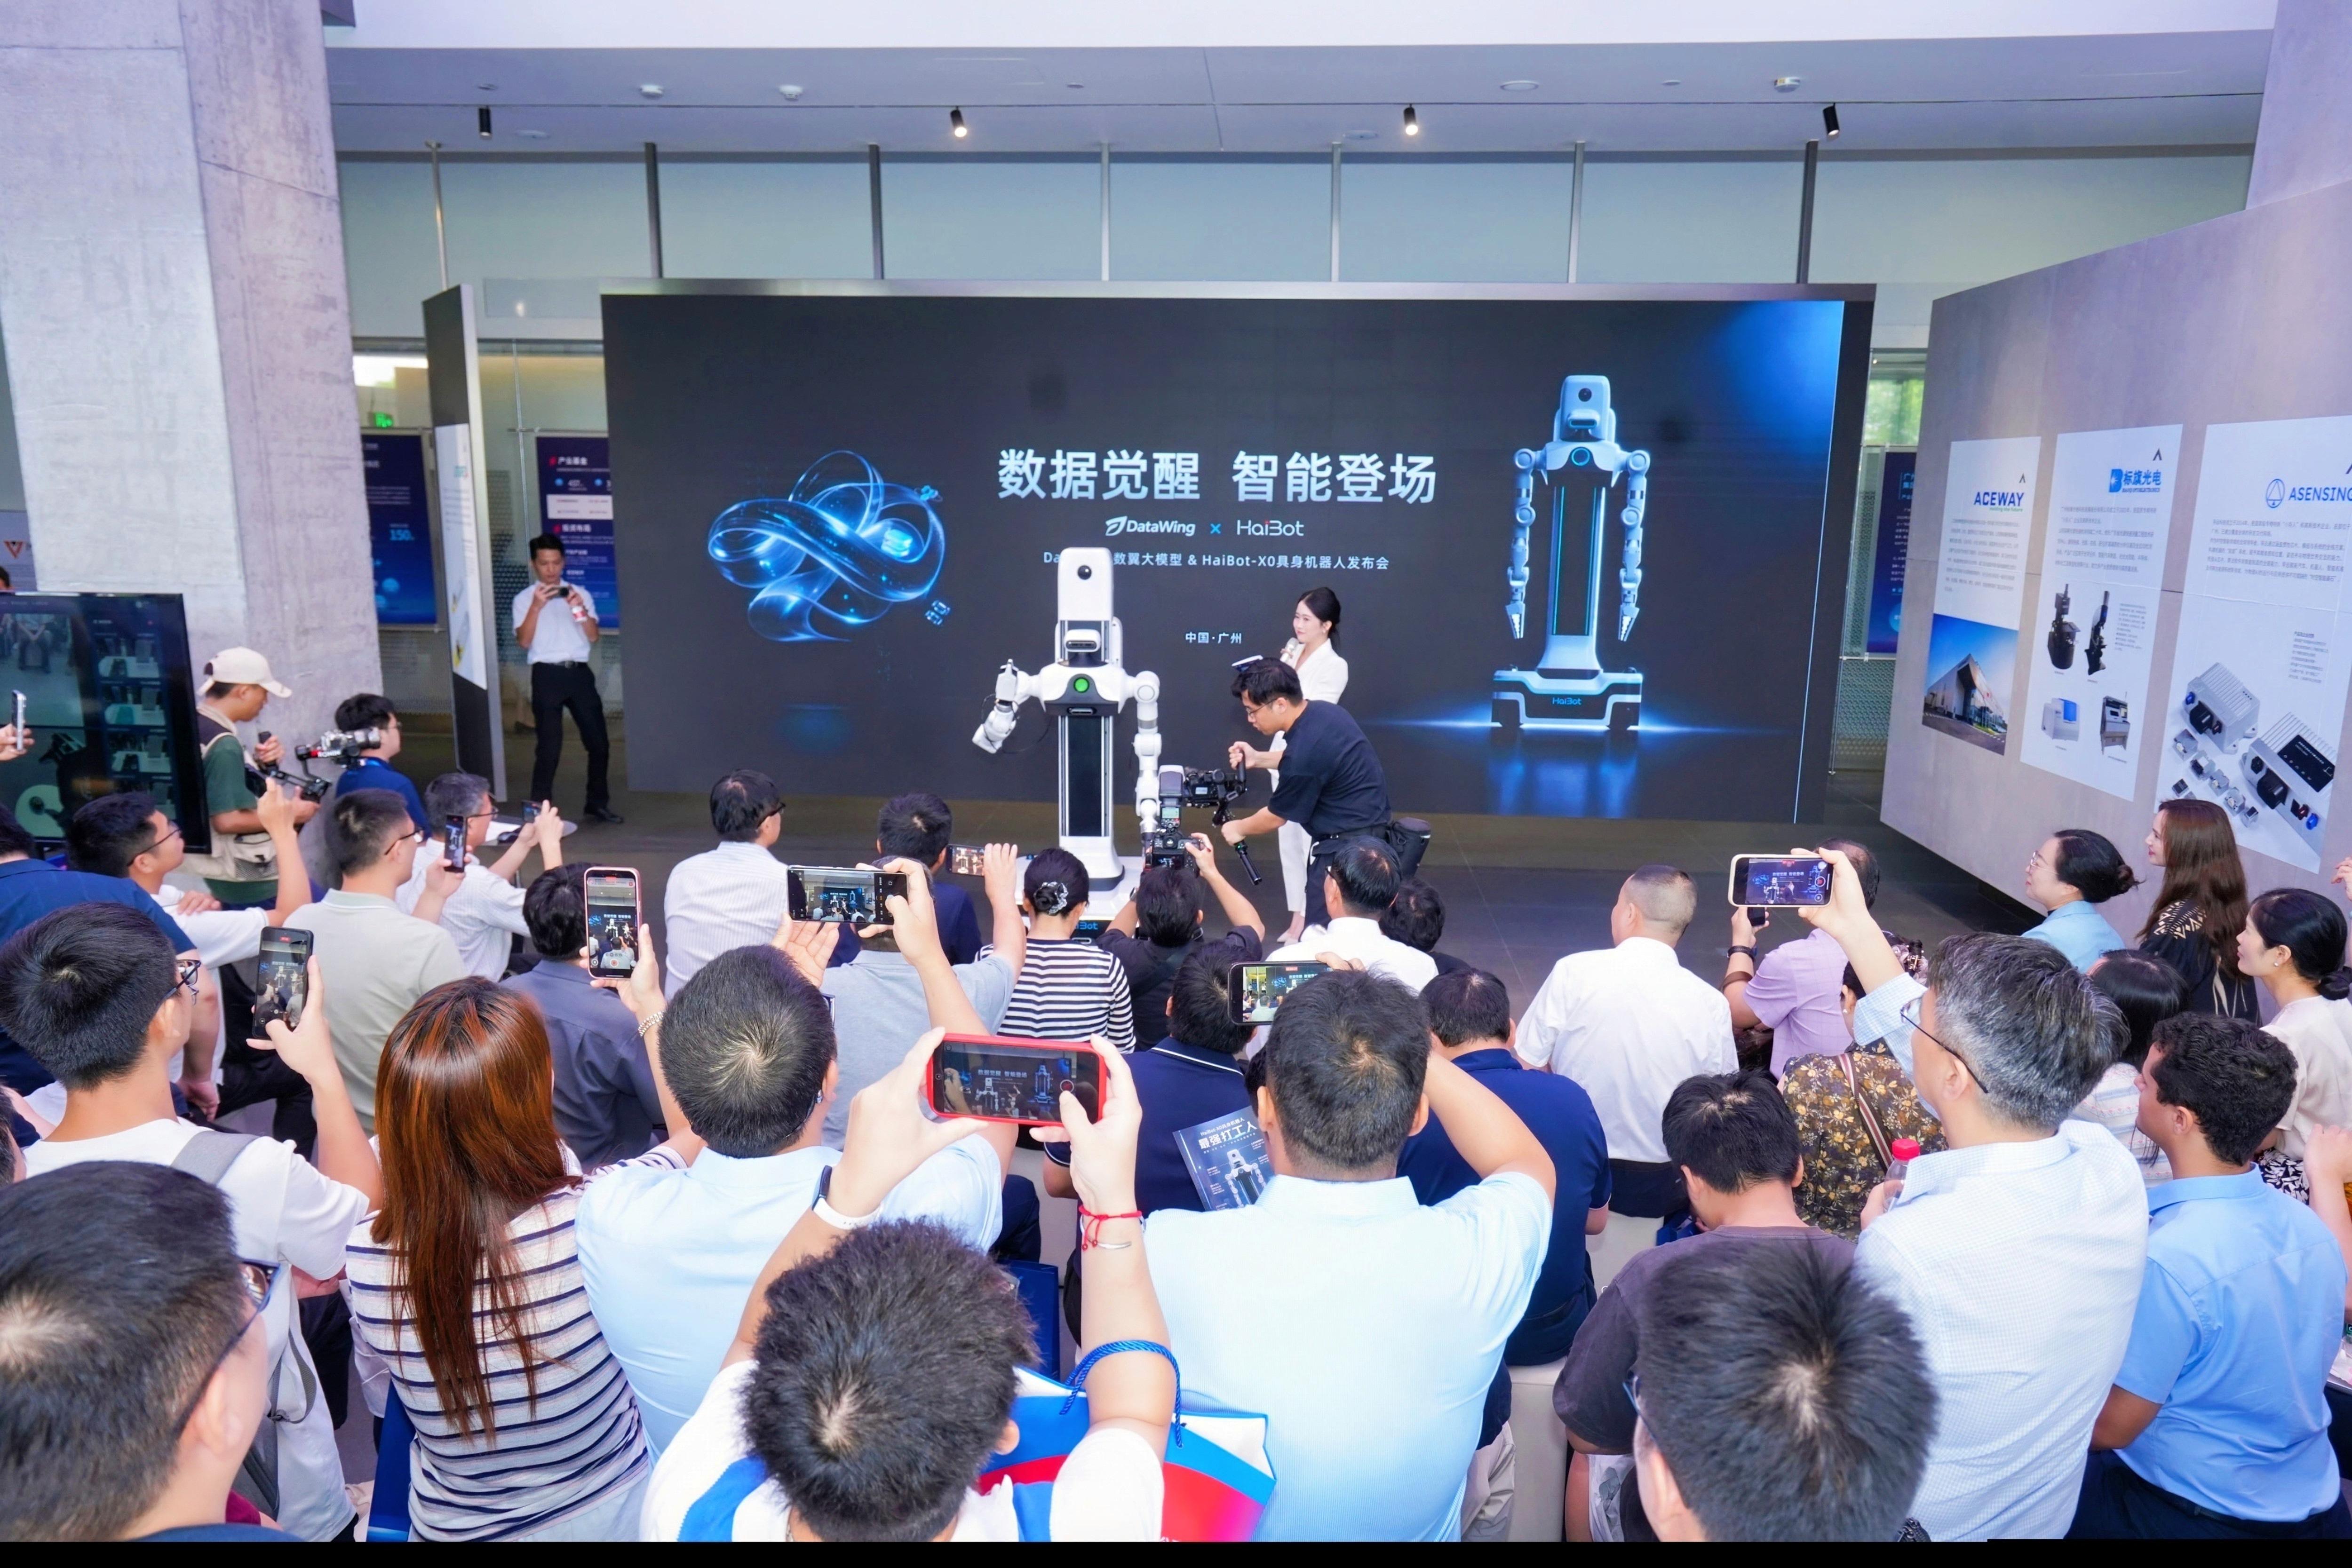
今年9月,工业AI服务商斯睿特智能首次对外展示基于9年沉淀、48TB真实场景数据训练的增广式工业大模型“数翼DataWing”,以及搭载具身大小脑模型CogniMotor与预见式世界行动模型SeerWAM的机器人HaiBot。企业接入后,一句话、一张图就能调用对应Skill,数据生成效率较人工采集提升10倍以上。
这家公司在聚光灯外待了很久,但对汽车行业而言绝非无名之辈:它是国内首家进入国际豪华车企供应链的本土工业AI品牌,持有93项以上知识产权;近百家工业终端客户,其中一半以上是头部车企;同时,斯睿特的工业AI解决方案实现冲压、焊装、涂装、总装四大核心工艺全覆盖,这套方案在本土工业AI公司中没有竞争对手,三年复购率超过60%。
当下,大模型与具身两大赛道的热潮都在回落,资本与客户都在追问:打榜、跑分之外,谁能带来真实价值?而斯睿特恰好回应了两者商业化的共同命题:如何将模型能力转化为工业级的确定性。
九年磨一剑:别人烧钱采数据,它把产线变成“数据油田”
看上去,数翼DataWing门槛很低。开箱即用的背后,是它在解决长期困扰工业AI的矛盾:企业亟需AI提效,却难以持续完成高质量多模态数据采集,训练不出适配的模型。
相比C端大模型,工业数据更为稀缺:工厂保密程度高,数据只有在客户验收前才开放;哪怕是头部机器人公司,也只能在夜间停工后进场采集有限数据。工业AI数据的持续供给,本质上依赖企业的商誉,这包括客户信任和工程交付能力。这二者加持下,企业持续进入新项目,才能补充一手工况。
“无论参与者有多少资本,都需要从头开始去现场采数据,所以数据是非常珍贵的资源。”斯睿特董事长贾春英告诉36氪。
对此,斯睿特的解法是真实和合成数据驱动的双轮飞轮。
其实行业中,数据的绝对数量并不低,但真正缺少的是高质量的数据。这些数据需要覆盖不同场景,同时缺陷数据占比足够低,这样才能保证机器学习的多样性和准确度。
而斯睿特采集的48TB数据中,覆盖17类场景、缺陷不足2%的,能持续地给模型供给多元、完整的数据原料。
但真实数据存在的问题是,它需要等待某个真实场景实际发生,这会浪费大量时间。所以,斯睿特同时引入VR/AR遥操数据作示教,再搭配世界模型仿真合成,尽可能形成多维度的数字孪生。最后,这一模拟场景与真机执行回流拟合,“视、触、力、动作”四模在同一时空轴上绑定,由产线数据优化孪生数据,实现“产线即数据工厂”。这也就是其生成式增广的核心。
但这其中最大的挑战在于工艺理解:一道划痕是否构成缺陷,要结合位置、尺寸和客户质量标准判断——生成一张带裂纹的图片,与生成一份有效的工业训练样本之间,隔着工艺经验的距离。
斯睿特从2019年就浸泡于汽车产线,在和客户的磨合中逐渐塑造出对工艺数字化处理的方法论,包括去理解工艺背后的原理、缺陷发生的环境等。行业中,汽车产线被称为“工业制造皇冠上的明珠”,四大工艺几乎覆盖所有制造垂类。在这种高强度、高要求、高标准的锻造中,斯睿特逐渐成长为汽车四大工艺的专家。
如今,它仅用10张实拍图片,就能启动大模型生成缺陷样本。以头部车企落地的“哑光+亮面”一体化漆面外观检测为例,其AI智能体相比同类方案落地时间缩短一半,识别准确率超过98%。
不卷人形卷大脑:与“Demo系”具身机器人拉开代差
和AI大模型类似,具身机器人也进入商业化深水区。一位行业人士告诉36氪,如今投资人不再看PPT,而是一批批奔赴工厂,看机器人在厂房里干活,而非在展示间表演设定好的流程;讲愿景、靠Demo融资的模式已经走到尽头。
而斯睿特的机器人,已经在客户工厂里穿梭上下货。
与当前市面上的具身机器人公司相比,斯睿特不卷本体、卷大脑。它没有跟风人形整机,而是聚焦分拣、搬运、组装、质检四类功能,研发资源集中于数据引擎与具身模型,硬件交伙伴协同。
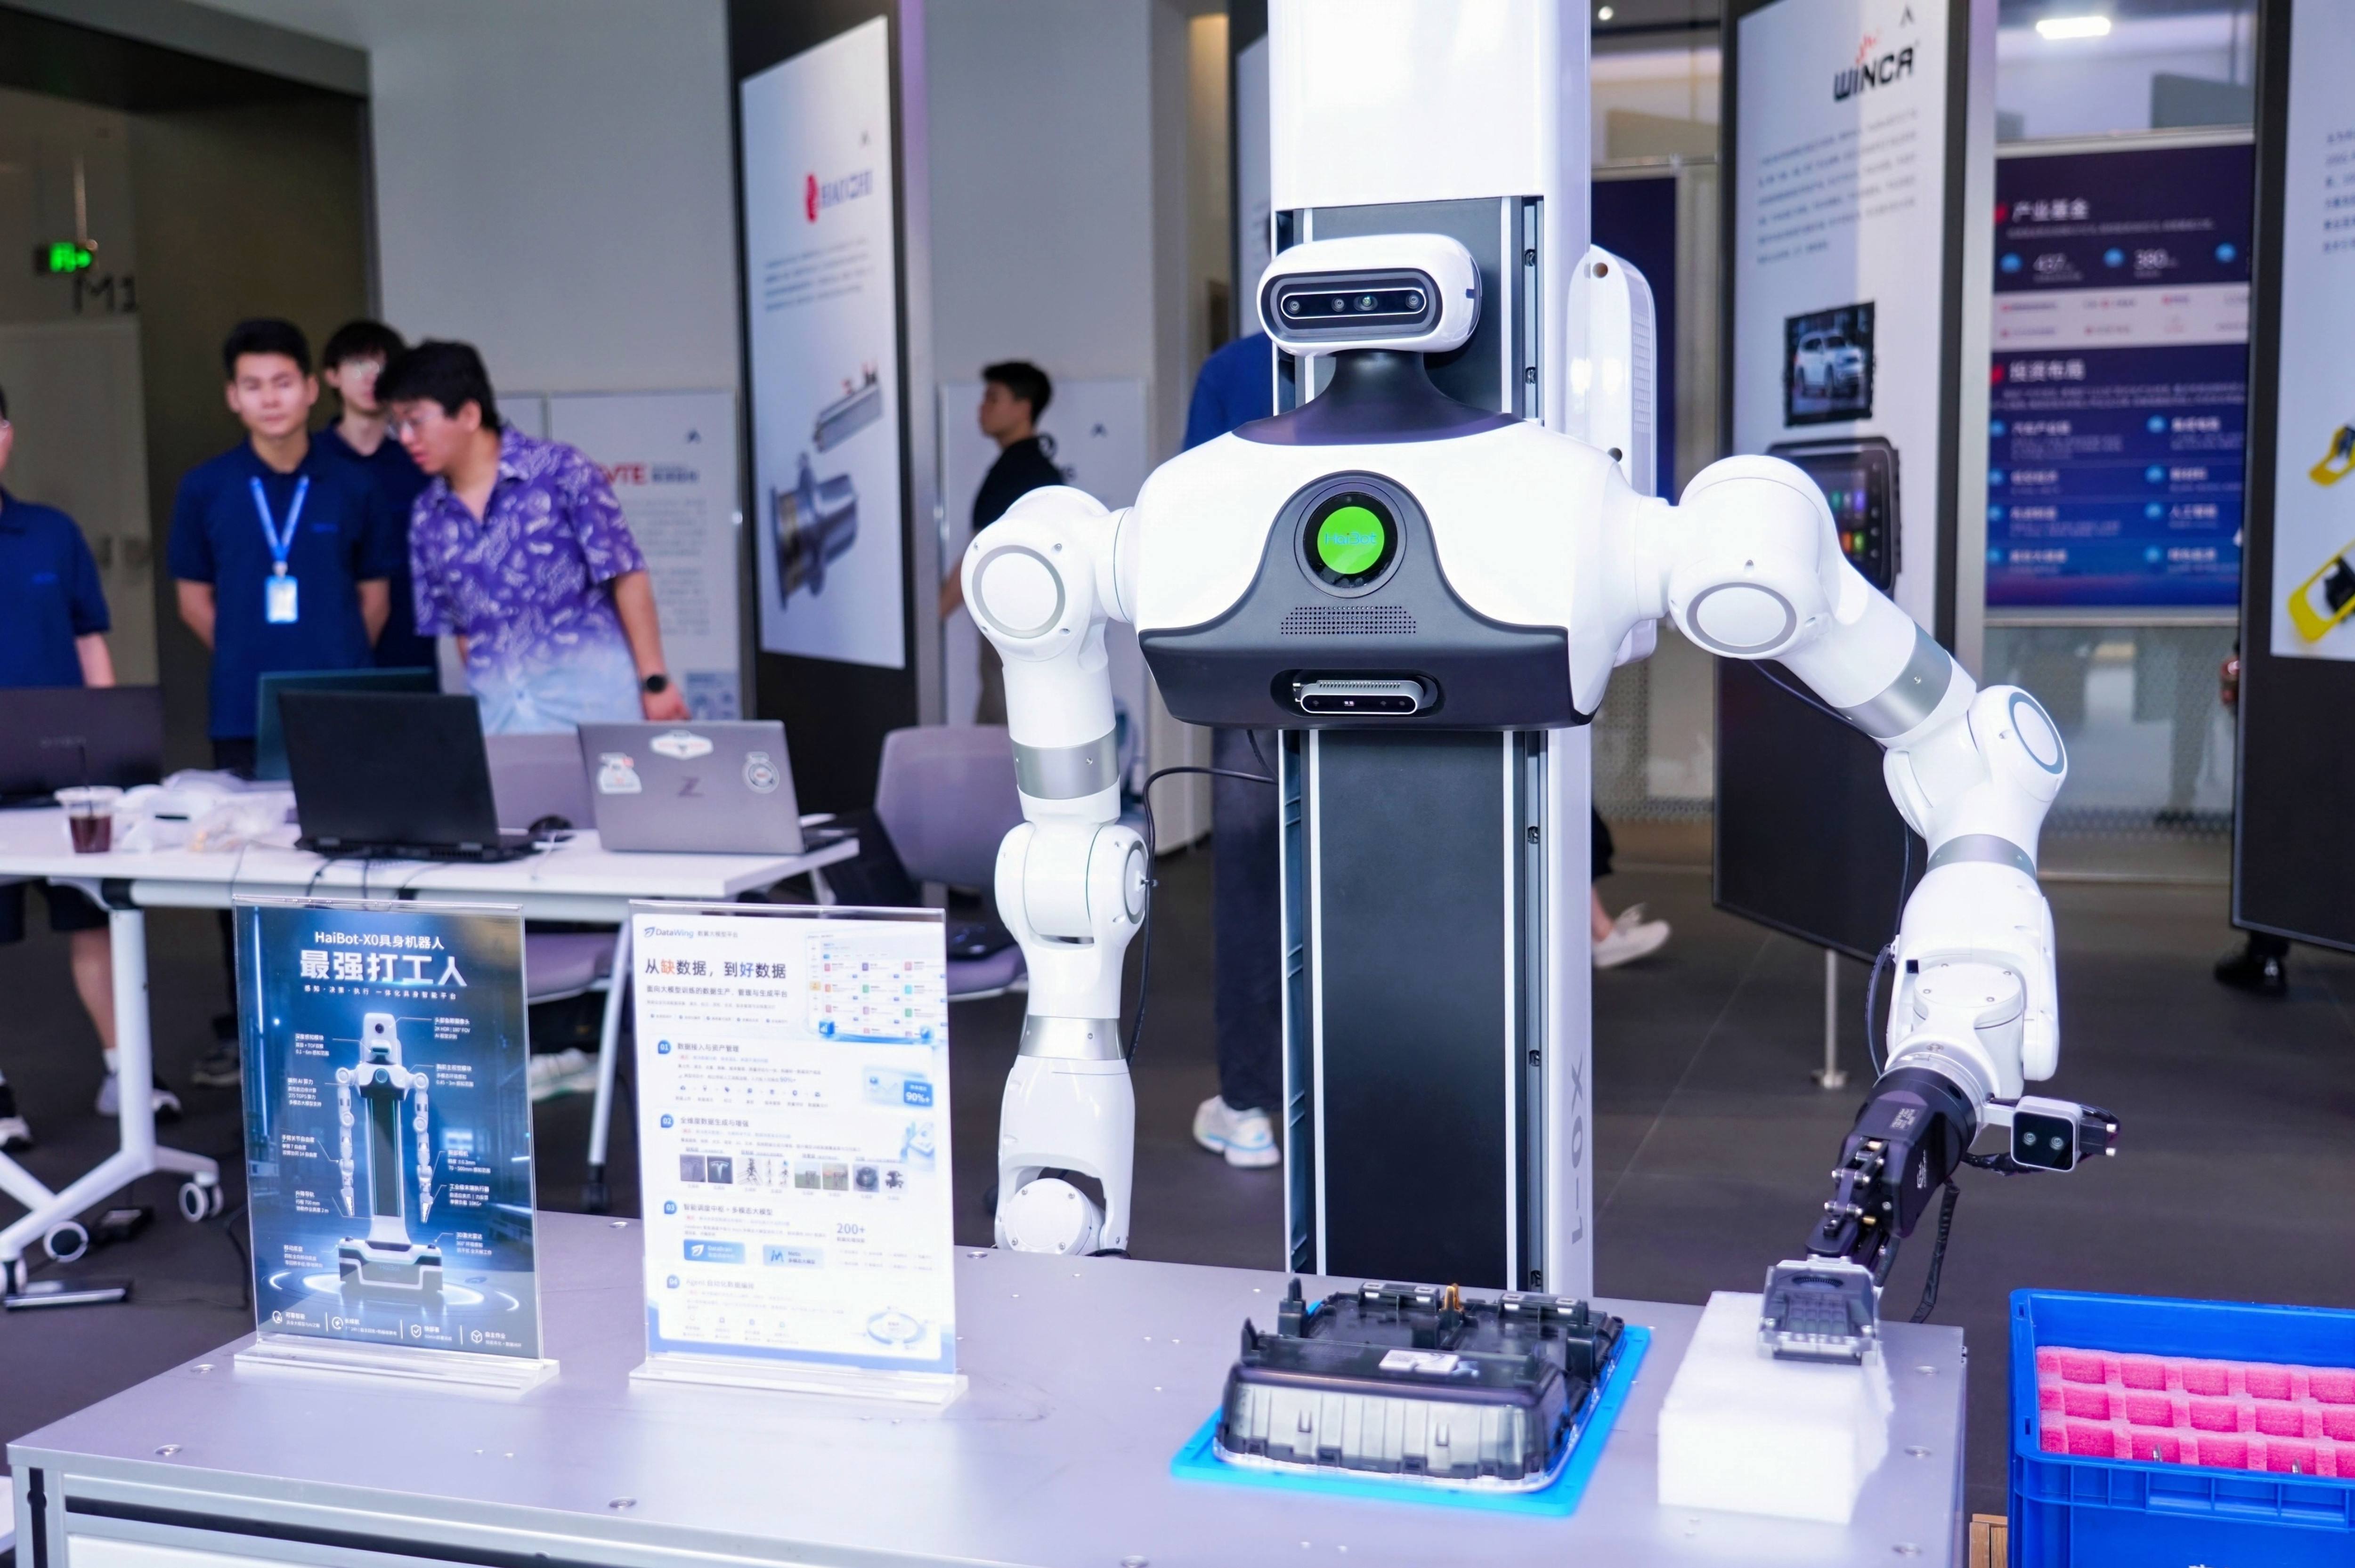
在大脑侧,CogniMotor承担任务理解、分解与规划;世界模型SeerWAM则在动作发生前预演,判断环境可能怎样变化、执行中可能出现哪些干扰。
在真实落地中,这些动作都要执行门控“先评分、再放行”。“先想后做”的预测式决策,是工业落地与实验室演示的分水岭。
然而,仅仅依靠视觉数据训练的大小脑和世界模型,无法解决工业操作“最后一厘米”的问题。机器人和物理接触之后,经常出现工件偏移、接触形变、装配阻力,这些多维度的物理量,构成了视觉路线的结构性上限。
对此,斯睿特的解法是“手眼脑协同”。除了视觉数据,斯睿特引入力触觉与视觉融合感知,让机器人在接触的瞬间“有手感”,真机作业后的力触觉数据最后回流至数据引擎。
这一VTLA工业力触觉大模型才是斯睿特具身模型的核心。触觉是唯一能直接映射物理属性的原生感知,无法从互联网获得,只能从真实产线采集。行业调研显示,工业力触觉训推耦合方向尚有约12-18个月的卡位窗口期,可以说,力触觉数据是行业供给为零的空白品类,对于纯视觉玩家而言,这是补不上的课,也是先行者的数据资产。
有了力触觉数据后,叠加视觉、语言、声音、语义等多模态数据,最终斯睿特构架起“VLA动作生成—世界模型预演评价—执行门控—真机执行”的物理训推耦合链路,视触力在真实接触中闭环。
VTLA工业力触觉大模型背后,归根到底还是优质客户场景的密度。斯睿特9年深耕积累近百家工业终端、过半为头部车企的场景网络,且冲、焊、涂、总四大工艺全覆盖,场景蜂窝密度极高。效果也已体现在工艺指标上:HaiBot双臂负载达20kg,落地部署头部车企的行业首套四模态智能作业精度可达0.1mm。
其实,在产品推出前,斯睿特将资源集中在大脑和触觉大模型都显得有些不合时宜。因为本体销售是最直观的变现渠道,而大模型需要大量时间训练,短期内无法看到成效。
斯睿特主动选择这条更难的路,底气来自检测主业多年的自我造血。它们不靠融资续命,技术投入服从产业规律而非资本节奏。
对于斯睿特而言,做大脑背后是更大的雄心,也就是做真正的工业具身生态:不围着自己的本体做全栈封闭,而是让模型与能力开放,输送到不同形态的机器人和生产场景,并计划在2029年推进不同机器人形态的异构适配。
这与“通用大脑派”并非消耗战,而是分层竞合。通用大脑横向铺开行业,斯睿特以“VTLA+触觉世界模型”实现行业首套四模对齐的垂直工业具身大脑,最终将具身能力释放到千行百业。
在商业模式上,其数据服务、智能工位、模型授权、触觉仿真数据与质检五个变现出口共用一个数据飞轮,让每一元收入同时是收入和数据。
四张无法速成的入场券
工业具身其实并非新话题,头部公司争相讲述相似叙事,它们的机器人也在龙旗等手机代工厂MMIT工站完成上下料作业。
但抛开演示,工业终究是长坡厚雪赛道,以车企供应链为例,其认证周期普遍长达2-3年,对合作方进入产线采集数据也相当谨慎。即便进入产线,要行成斯睿特那样48TB真实产线数据与10万小时样本库,要耗费数年时间。更重要的是,产线上的工程落地实践写不进论文,是经验性资产,也无法通过纸面学习快速习得。加上很多公司缺少造血能力,实际上根本没有能力拿到进入工业AI和具身的长期入场券。
行业之中,一些技术路线想用仿真数据补齐短板,但维度单一,难以构建真正的多维数字孪生;而真机数据昂贵、可迁移性低,工业场景又因保密性压缩了采集渠道。这也解释了产业的困局,行业喧嚣,但真实数据仍旧稀缺。
斯睿特决定承担这个赋能者的角色。
当下,开放能力正成为物理AI的重要方向,英伟达将世界模型与训练评估框架向行业开放,正是平台化技术供给思路。斯睿特也希望成为这样的核心能力供给者:把长期积累的工艺经验,转化为赋能产业的共同底座。
更重要的是,工业AI和具身的市场规模天花板足够高。汽车是最严苛的验证场——节拍、精度、安全、认证都要层层筛选,而斯睿特针对复杂工业场景的具身POC,在头部车企7天即完成验收。
从最难场景毕业,等于拿到泛工业的通行证。对斯睿特而言,垂直是入口不是边界,它们在汽车产线积累的抓取、涂胶、搬运、检测Know How,依托世界模型增广微调,到新产线适配周期能压缩至数周。斯睿特9年的工业积累,正通过大模型重新组织,从一次性的工程交付,变成可复用、可授权、可跨行业流动的智能资产。
对产业而言,这是一条更务实的智能化路径:AI从最懂工艺的地方长出来,把多品种、小批量、频繁换线的柔性制造难题,变成可规模化承接的确定性任务。
当这些能力成为千行百业智能化跃迁的底座,工业具身就不再是机器人的销售,而是制造范式的基础设施升级。机器人行业的竞争,正在从“谁的Demo更惊艳”,转向“谁能把场景沉淀为可持续复利的资产”。
而真正定义下一个十年的,不是最会讲故事的公司,而是以长期主义将时间沉淀为壁垒、厚积薄发的企业。汽车垂直的千亿级深井只是开始,之后是泛工业的万亿级空间,最终,头部工业具身和AI大模型公司,必然走向开放式的通用+垂直平台。而斯睿特这样有数据资产、有造血能力、有技术Know-How的企业,终将在产业兑现时刻集中释放。