
 搜索

给大模型装上“一双耳朵”:小米开源空间音频理解大模型 MiDashengLM-Spatial
3 小时前
/ 阅读约2分钟
来源:IT之家
小米发布MiDashengLM-Spatial模型,为声音理解大模型赋予空间感知能力,是业界首个开源的端到端空间音频理解大模型,将应用于智能家居、汽车座舱等场景。
IT之家 10 月 16 日消息,小米昨日宣布,带来 Dasheng 系列的重要新成员 ——MiDashengLM-Spatial,完整公开模型权重和推理代码,并以 Apache 2.0 许可证发布。
过去两年,小米先后发布并开源了声音基座模型 Xiaomi Dasheng 及声音理解大模型 MiDashengLM-7B。相关技术已在小米智能家居、汽车座舱等场景实现超过 30 项落地应用,能够对语音、环境声音和音乐进行统一感知与理解。
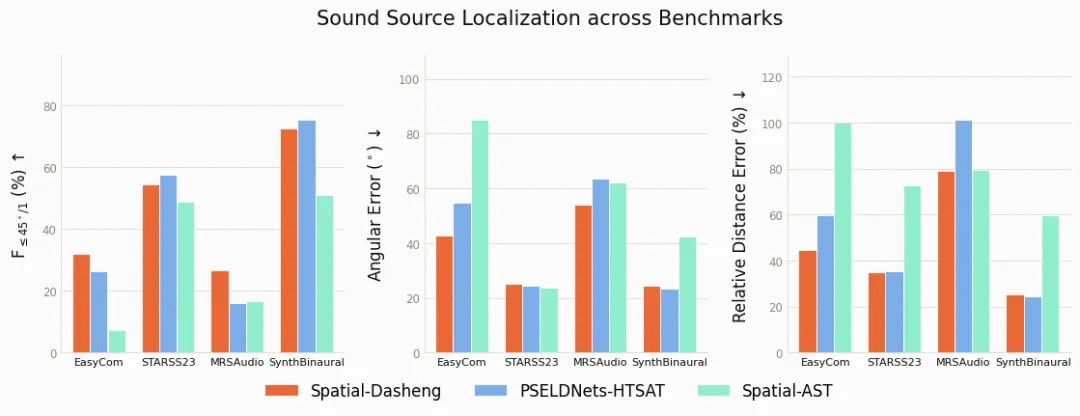
据介绍,新模型以 MiDashengLM-7B 为基座,进一步为声音理解大模型赋予“一双耳朵”,使其不仅能够听懂声音的内容,还能感知声音来自何处、如何在空间中分布。
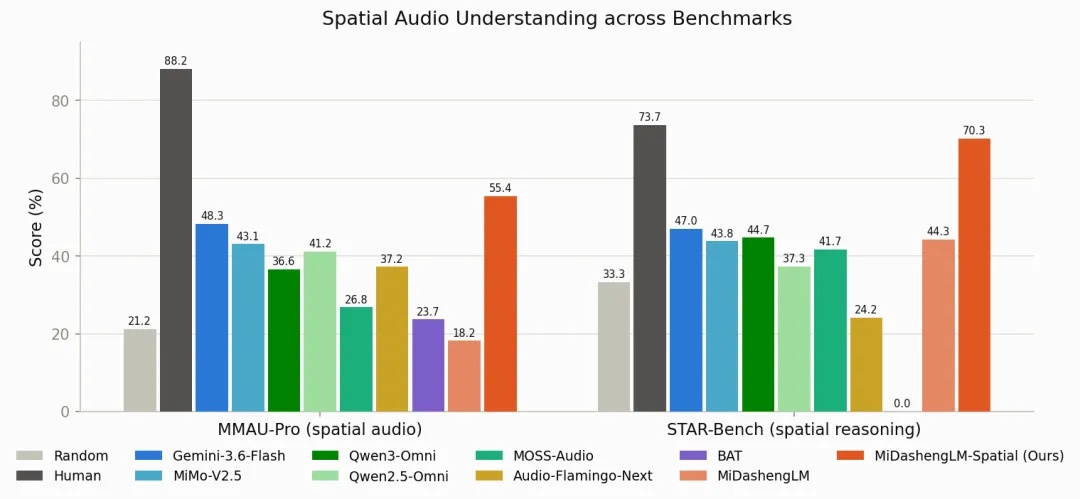
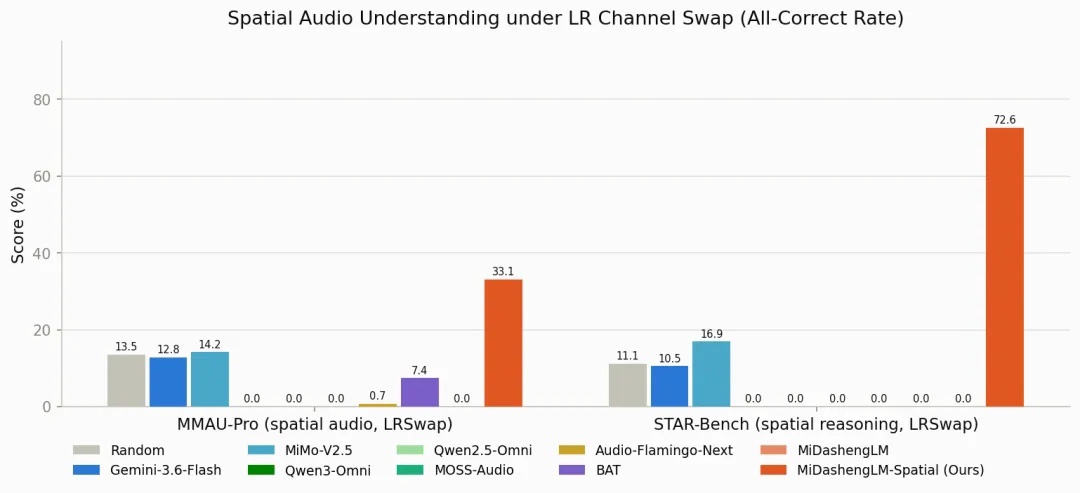
小米表示,MiDashengLM-Spatial 是业界首个开源的端到端空间音频理解大模型,在保留基础音频理解能力的同时,具备空间感知与推理能力,推动音频大模型从“听懂声音”进一步迈向“理解声音所处的空间”。
该模型将陆续应用于小米智能家居、汽车座舱等场景,以空间听觉能力进一步提升“人车家全生态”的交互体验。相关测试数据如下:
IT之家附相关链接:
项目主页:https://jinbo-hu.github.io/midashenglm-spatial-demo/
技术报告:https://arxiv.org/abs/2610.11156
评估代码(GitHub): https://github.com/xiaomi-research/midashenglm-spatial
模型结构与权重(HuggingFace):https://huggingface.co/mispeech/midashenglm-spatial