
 搜索

美国当地时间10月21日,AI创业公司Recursive发布了开源模型Flint。这是一款总参数量约400亿、面向本地编码智能体的混合专家(MoE)语言模型,SWE-bench Pro v2得分达到89.7%。
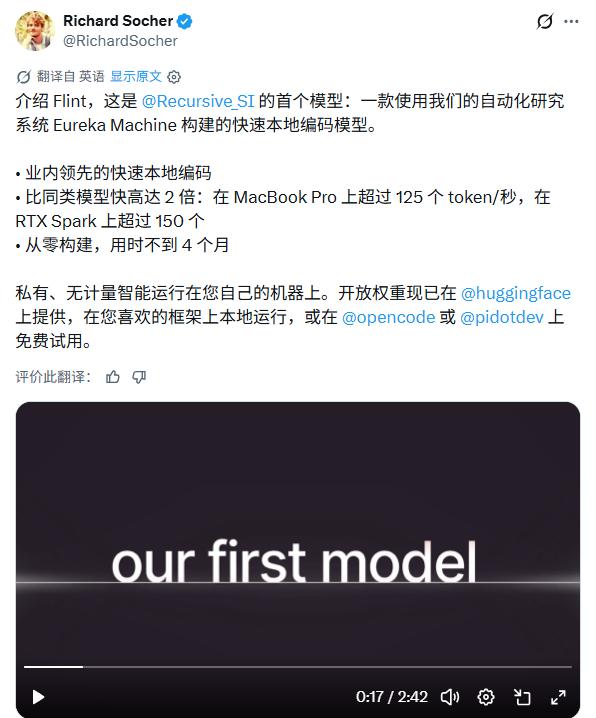
相比模型参数和Benchmark成绩,Flint更受关注的地方在于它的研发方式。从架构搜索、量化方案到GPU内核优化,Recursive旗下AI研究系统Eureka Machine参与了模型研发的几乎所有环节。
也可以不太准确地说,“AI开始造AI”,但也只能说是个“开始”。整个过程不到四个月,模型从零开始完成训练。
Recursive由前Salesforce首席科学家理查德·索切尔(Richard Socher)创立,前Meta首席研究员、YOLO算法原创作者田渊栋也是联合创始人。索切尔将Flint称为Eureka Machine的首个真实应用案例。
Flint的模型权重已在Hugging Face开放,采用Apache 2.0协议,允许个人和企业免费使用、修改和商用。
这次发布也让一个问题有了更具体的讨论对象:AI已经能在多大程度上参与构建AI?
01、AI参与“三大”环节
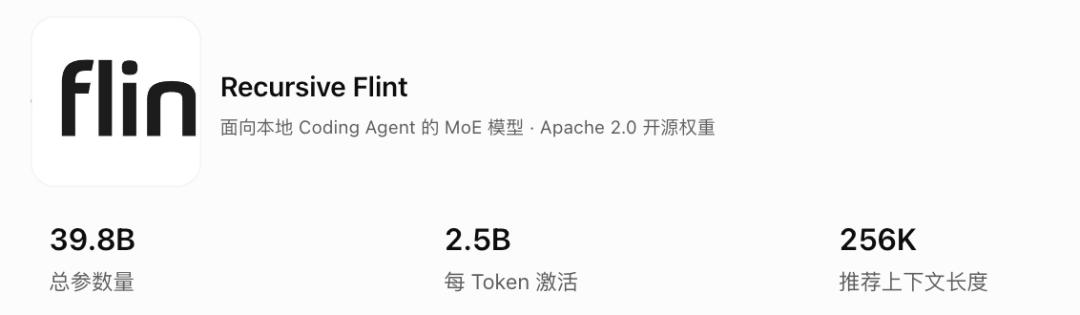
Flint采用MoE架构,总参数量398亿,但每个token只激活少量参数。模型包含256个路由专家,每次计算激活其中6个,另有一个共享专家始终参与计算。按官方披露的数据,运行时实际激活参数约25亿。
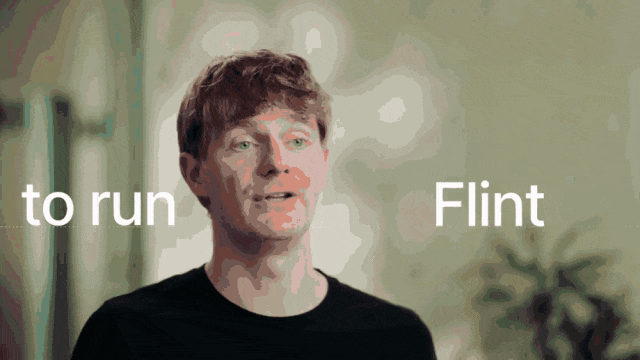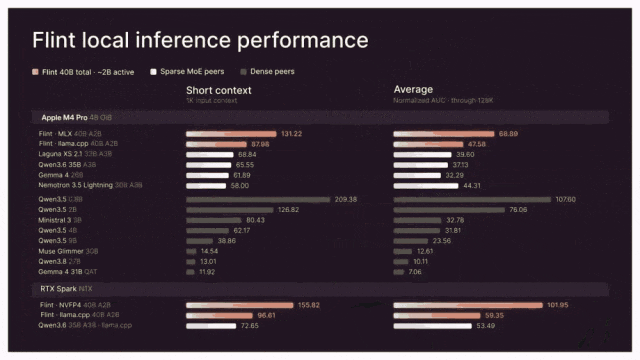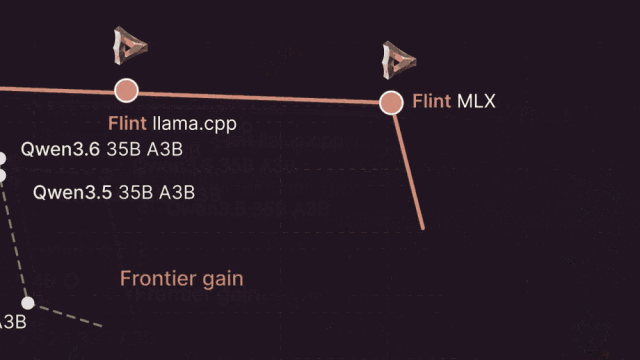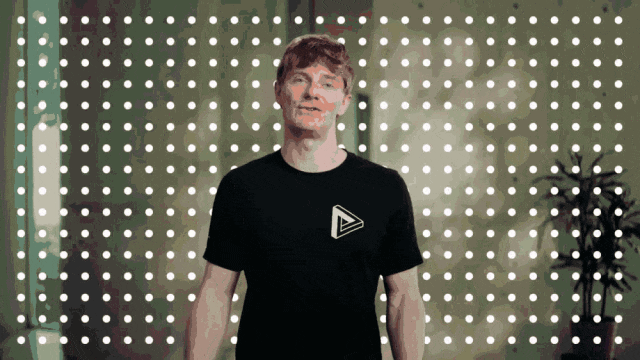
这种设计减少了每次推理需要执行的计算量,也降低了本地部署的门槛。官方展示的测试结果显示,Flint在搭载48GB内存的Apple M4 Pro上,推理速度达到每秒131.22个token。在RTX Spark NIX平台上达到每秒155.82个token。官方称,其速度领先于部分同类模型。
Flint支持最长256K token的上下文,覆盖提示词和生成内容。Recursive还针对英伟达显卡和Apple Silicon设备提供了相应的量化版本与推理工具。
在基准测试中,Flint以“小体格”打出了“大动静”。它在编程、终端操作和指令遵循上,几乎全面压制了同等硬件能跑的对手(比如Qwen 3.5/3.6和Laguna),部分指标甚至越级击败了体量更大的稠密模型(如Qwen 3.8和Gemma 4)。
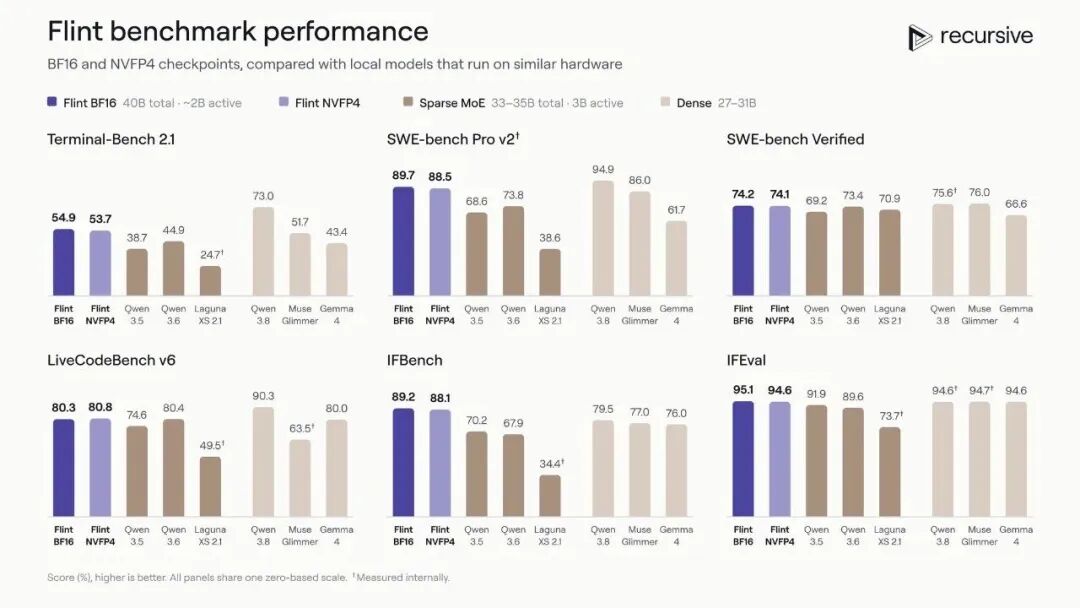
在复杂软件工程任务上,Flint的表现尤其出挑,SWE-bench Pro v2冲到了近90%的高度;而在指令遵循(IFBench)上,它直接拿下了全场最高分,证明自己不仅会写代码,也非常“听话”。
此外,它的NVFP4量化版本几乎没掉性能,这意味着在实际部署时,能极好地平衡速度、显存和聪明程度。

在打造Flint的过程中,Eureka Machine主要参与了三大环节。
首先是架构搜索。Flint共有49层,其中2层采用密集结构,另外47层采用MoE结构。注意力机制则结合滑动窗口与全注意力。
官方资料显示,模型使用35层滑动窗口注意力和14层全注意力,并将窗口设为513个token。这些配置经过自动化探索与测试确定,而非完全依赖研究人员手工设计。
其次是量化。Recursive称,Eureka Machine将模型体积缩小了约71%,同时尽量控制精度损失。模型压缩后,更容易在消费级硬件上运行。

索切尔接受《连线》(WIRED)采访时表示,他曾在配备48GB内存的Mac上使用Flint,完成命令行待办工具、网页爬虫和RSI原理介绍网站等小项目。
第三是GPU内核优化。针对不同硬件调整底层计算实现,有助于提升推理速度。传统研发需要工程师反复编写、编译和测试内核,Eureka Machine则将这些工作纳入自动化流程。
Flint的训练也从零开始,依次经过分词器构建、预训练、中段训练、监督微调和强化学习等阶段。Eureka Machine参与了整个训练管道的多个环节,并在不到四个月内完成了这款模型。
02、距离真正的“AI造AI”还很远
Flint的意义,主要在于它展示了一种新的研发组织方式:让AI系统承担模型研究中的部分试错工作。
按照Recursive的介绍,Eureka Machine会提出候选方案、执行实验、检查结果,再根据反馈决定下一步尝试。它可以搜索架构配置、比较量化方案,也能针对特定硬件优化GPU内核。原本需要研究人员反复操作的实验环节,由此得到自动化处理。
不过,这与完全自主的递归自我改进(RSI)仍有距离。
所谓递归自我改进,通常指AI不仅能够改进自身或相关系统,还能自主决定改进方向,并持续推进下一轮改进。按照目前公开的信息,Eureka Machine主要在既定研发目标和约束下优化方案。研究问题由谁提出、优化目标如何设定,以及哪些结果值得继续投入,仍离不开人类的参与。
因此,Flint证明的是AI已经能够实质性参与模型研发,而不是AI已经可以独立完成整个AI研究过程。
这一区别很重要。自动化实验可以提高研发效率,却不等于系统已经具备自主提出科学问题、判断研究价值和制定长期目标的能力。Recursive希望最终实现更高程度的递归自我改进,但Flint还不能证明这一目标已经实现。
03、新模型全面开源
Flint采用Apache 2.0协议开放权重,相关文件托管在Hugging Face上,包括模型配置、分词器、聊天模板和BF16检查点,并提供SGLang推理工具包。开发者可以自行部署模型,也可以根据需求进行修改和量化。
不过,开放权重不等于所有研发环节都已完全开源。部分建模代码仍在完善中,企业托管API、服务等级协议(SLA)等商业服务也尚未公布。企业若要在生产环境中使用Flint,需要自行承担部署、维护和数据安全责任。
Recursive的资金实力则为这项研究提供了支撑。公司此前已完成6.5亿美元融资,估值达到46.5亿美元。投资方包括谷歌风投、Greycroft、英伟达和AMD Ventures。
除索切尔和田渊栋外,Recursive的联合创始人还包括杰夫·克伦(Jeff Clune)。他是不列颠哥伦比亚大学教授,长期研究能够持续学习和进化的AI系统。
这支团队希望将自动化研究做成一套可复用的系统,而不只是用AI辅助训练某一个模型。Flint是这套系统的首次公开成果,后续模型能否进一步证明其效率和可扩展性,将决定这一思路的实际价值。
04、自动化的边界
随着AI开始参与自身研发,自动化研究的安全问题也受到关注。
围绕递归自我改进,AI安全研究人员一直存在分歧。一种担忧是,如果AI未来能够自主设计实验、修改系统并持续提升自身能力,人类可能越来越难以预测和控制其发展方向。另一种观点则认为,当前系统距离这种自主能力仍然很远,过早限制相关研究可能阻碍技术进步。
索切尔认为,外界对失控风险的部分担忧被夸大了。他强调,Eureka Machine目前仍处于人类监督之下,研发过程围绕明确的任务展开,研究人员能够检查结果并决定是否继续。
但人类保留最终决定权,并不代表自动化系统不需要审查。随着实验数量增加,研究人员仍需确认测试是否可靠、优化结果是否可复现,以及系统有没有在特定指标上取得进步、却牺牲其他重要能力。
Flint目前提供了一个可以下载和测试的案例:AI能够参与架构搜索、量化和内核优化,并将这些环节整合进模型研发流程。但它尚未证明AI可以脱离人类设定的目标,自主推动完整的研究循环。
对AI研究来说,Flint交出的第一份答卷,是把部分模型研发工作交给AI,并在不到四个月内完成一款开源模型。接下来可能要真的在应用中看看,这种方法能否稳定复现、推广到更复杂的模型,以及在扩大自动化程度后,研究人员能否还有足够的控制力。
AI的递归自我改进(RSI),当下最性感的领域之一,也是最让人忧心的领域之一。