
 搜索

智东西11月19日报道,近日,谷歌云AI、谷歌DeepMind与美国宾夕法尼亚州立大学的研究团队联合发布论文《自改进记忆,实现持续递归式自改进》(Self-Improvement Memory Enables Continual Recursive Self-Improvement),提出了一种名为自我改进记忆(Self-Improvement Memory,SIM)的新方法。
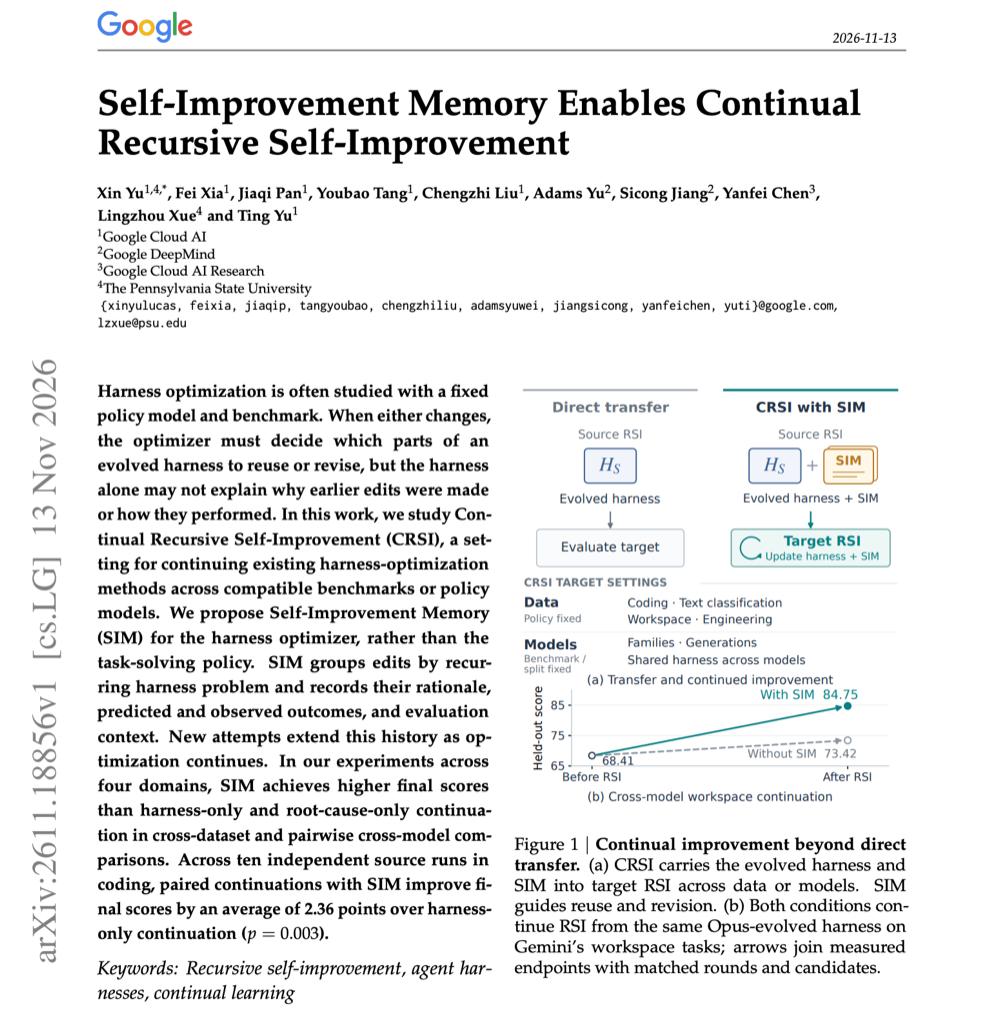
▲《自我改进记忆实现持续递归自我改进》
此前,AI虽然能够自主优化大模型外部的运行框架(Harness),但更换模型或任务后,往往需要重新优化。SIM首次将代码修改背后的原因、预期效果和实际结果组织成可持续更新的记忆,让AI能够继承并调整过去的改进经验,实现跨模型、跨任务的持续递归自我改进(CRSI)。
随后,研究团队在编程、文本分类、办公任务和工程设计四个领域展开测试。在10组独立编程对照实验中,引入SIM的方案有9组表现更好,平均领先2.36分。在另一项跨模型办公任务测试中,引入SIM的方案最终得分达到84.75分,未引入SIM的方案仅为73.42分,相差11.33分。
这项研究的第一作者Xin Yu于2023年毕业于南开大学统计学专业,目前正在美国宾夕法尼亚州立大学攻读统计学博士。这项研究是在其谷歌实习期间完成的。
▲Xin Yu
Xin Yu先后在微软亚洲研究院、字节跳动Seed、TikTok和Meta实习,还曾获微软亚洲研究院2023年“明日之星”奖。他参与的多篇研究论文发表于ICML、ICLR、NeurIPS等国际顶级人工智能学术会议。
论文另一位作者Adams Wei Yu则是谷歌DeepMind研究员,曾参与Gemini、Bard以及AI视频生成模型Veo等项目。
▲Adams Wei Yu
论文发布后,Xin Yu在X上介绍了这项工作的出发点。他提到,过去的递归自我改进研究通常针对固定的大模型和测试任务,但现实中的Agent需要不断适应新的任务、数据集和模型。因此,研究团队希望AI的优化经验能够随着环境变化持续积累。
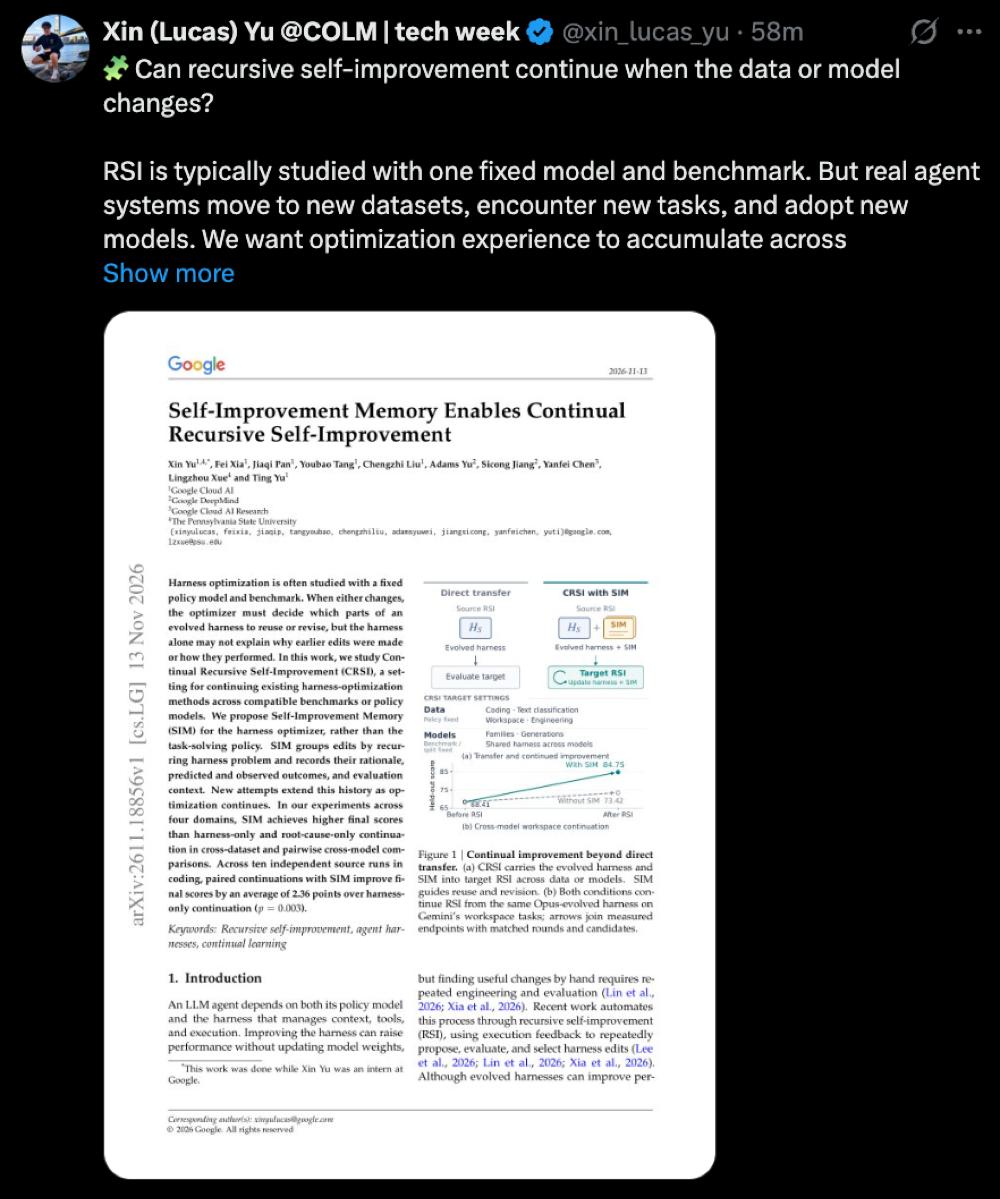
▲Xin Yu发文
“What carries forward should include the experience behind the code—not just the code itself.(应该传承下去的不只是代码本身,还有代码背后的改进经验。)”Xin Yu写道。
论文地址:https://arxiv.org/abs/2611.18856
01.
AI能自己修改代码
还能记住每次改进的成败
递归自我改进(Recursive Self-Improvement,RSI),指的是让AI参与改进AI系统,并通过反复迭代提升表现。在这项研究中,AI改进的对象不是大模型本身,而是围绕大模型运行的一套外部程序——Harness。
Harness负责管理提示词、上下文、工具调用和任务执行流程等。例如,让AI完成一项编程任务,Harness可以决定何时调用终端、如何检查代码运行结果,以及满足什么条件才能宣布任务完成。
通过RSI,AI可以自主修改Harness代码,反复测试修改效果,并保留表现更好的版本,从而在不更新大模型权重的情况下,提高Agent的任务完成率。
但这类优化通常针对固定的模型和任务。一套针对Claude优化好的Harness,换成Gemini后不一定仍然有效;此前针对编程任务设计的规则,也可能不适用于新的任务。
更重要的是,修改后的Harness虽然保留了代码,却不一定保留每次修改背后的原因和测试经验。当模型或任务变化时,负责优化的AI可能重复此前的尝试,还会删除原本有效的功能。
为此,研究团队提出持续递归自我改进(Continual Recursive Self-Improvement,CRSI),希望让Harness的自动优化能够跨模型、跨任务延续,并通过SIM保存此前的改进经验。SIM就像一本“实验记录本”,记录每次被采用的修改方案、修改原因、预期结果、实际效果,以及对应的模型和测试环境。
当新的任务或模型出现时,负责优化Harness的AI可以参考这些记录,判断哪些规则应该保留、修改或移除,而不必重新摸索。
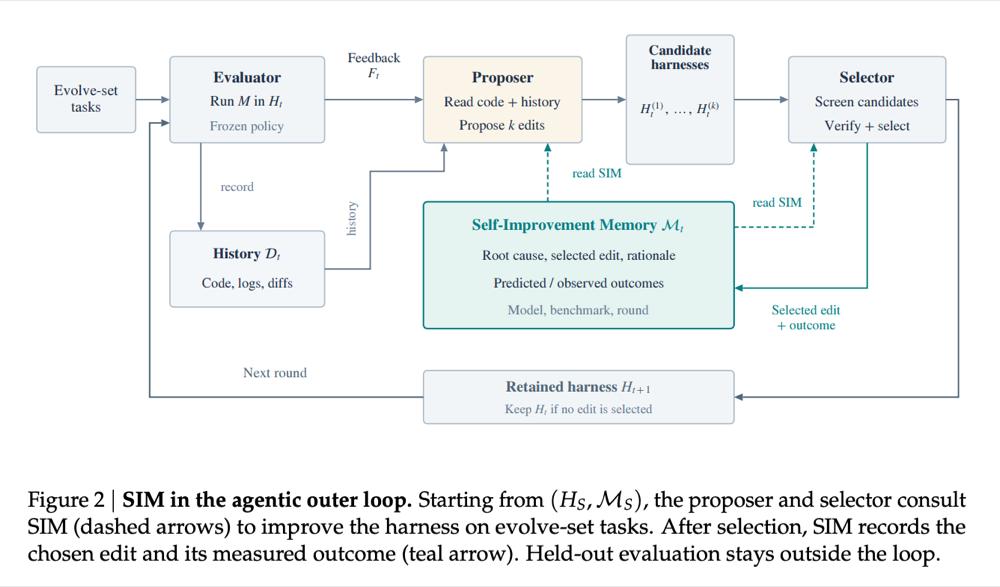
▲SIM工作流程
具体来说,系统中负责提出方案的AI会读取当前代码、执行反馈和SIM记录,生成新的修改方案;负责筛选的AI则检查候选方案,并结合测试结果决定是否采用。
随后,系统会把被采用的修改及其实际效果写入SIM。即使修改没有达到预期,失败结果也会被保留,供后续优化参考。
在一项Git服务器配置任务中,AI因本地测试成功便提前宣布任务完成,却遗漏了创建指定用户账号这一关键步骤,导致外部验证失败。研究人员通过自动优化,为运行框架加入了任务完成检查机制,避免AI在缺少执行证据时提前结束任务。
当测试切换到光波导布线任务后,又出现了新的问题:AI生成的布线路径虽然满足约束条件,却不代表布线成本已经足够低。于是,后续优化保留了此前的检查机制,同时增加对方案质量的检查提醒,避免AI仅凭通过基础约束检查就结束任务。
这也是SIM希望实现的效果:让AI既能沿用过去有效的改进方法,又能根据新任务的要求继续调整。
02.
10组编程实验9组获益
跨模型最高多拿11.33分
为了验证SIM的效果,研究团队进行了两类主要实验:一类保持底层模型不变,更换任务数据;另一类保持测试任务不变,更换底层模型。
在第一类实验中,研究人员使用Gemini 3.8 Flash作为底层模型,将已经优化过的运行框架迁移到新任务中。
结果,在覆盖编程、文本分类、办公任务和工程设计的6组测试中,引入完整SIM的方案均取得最高最终得分,相比仅沿用原有运行框架的方案领先2.43至4.35分。
第二类实验则涉及不同模型之间的迁移。研究人员先针对Claude Opus 5.5优化一套Harness,再让Gemini 3.8 Flash使用这套Harness,并继续开展自动优化。
结果发现,直接将Claude适用的Harness迁移到Gemini后,其在4个测试领域的初始表现都不如Gemini使用原始Harness时的表现。
但引入SIM后,负责优化的AI可以参考此前的修改经验,调整不适合Gemini的部分。最终,SIM方案在全部4个领域中取得最高得分,相比未引入SIM的方案领先3.60至11.33分。
其中差距最大的是办公任务测试。两种方案都从68.41分起步,引入SIM的方案最终达到84.75分,而没有SIM的方案为73.42分。
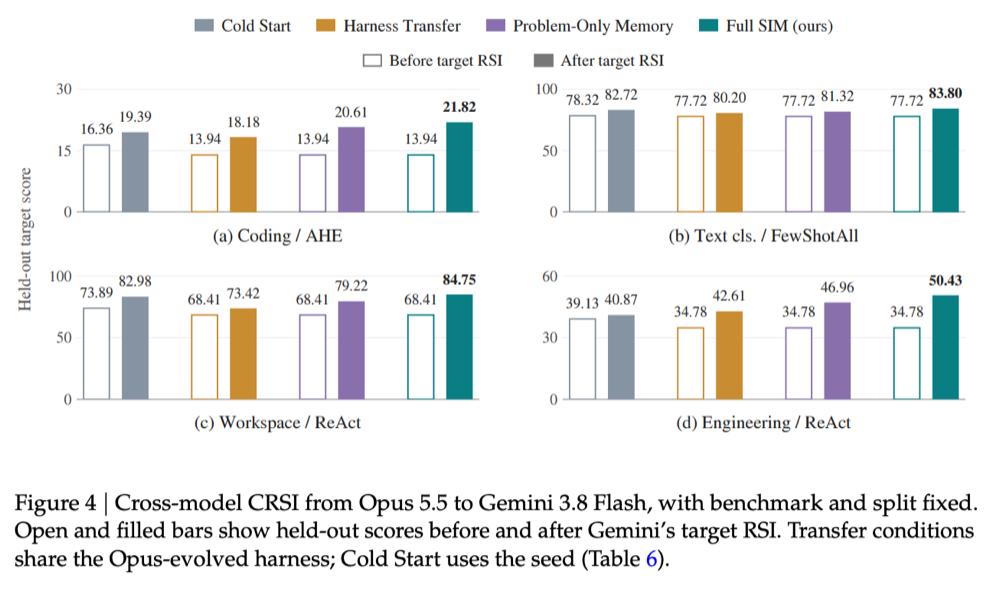
▲跨模型测试结果
为了进一步验证效果,研究人员还进行了10组独立编程对照实验。
在相同初始代码、底层模型、任务和优化预算下,加入SIM的方案有9组得分更高,平均最终得分为21.70分,没有SIM的方案平均为19.33分。两者平均相差2.36分,统计检验结果为p=0.003。
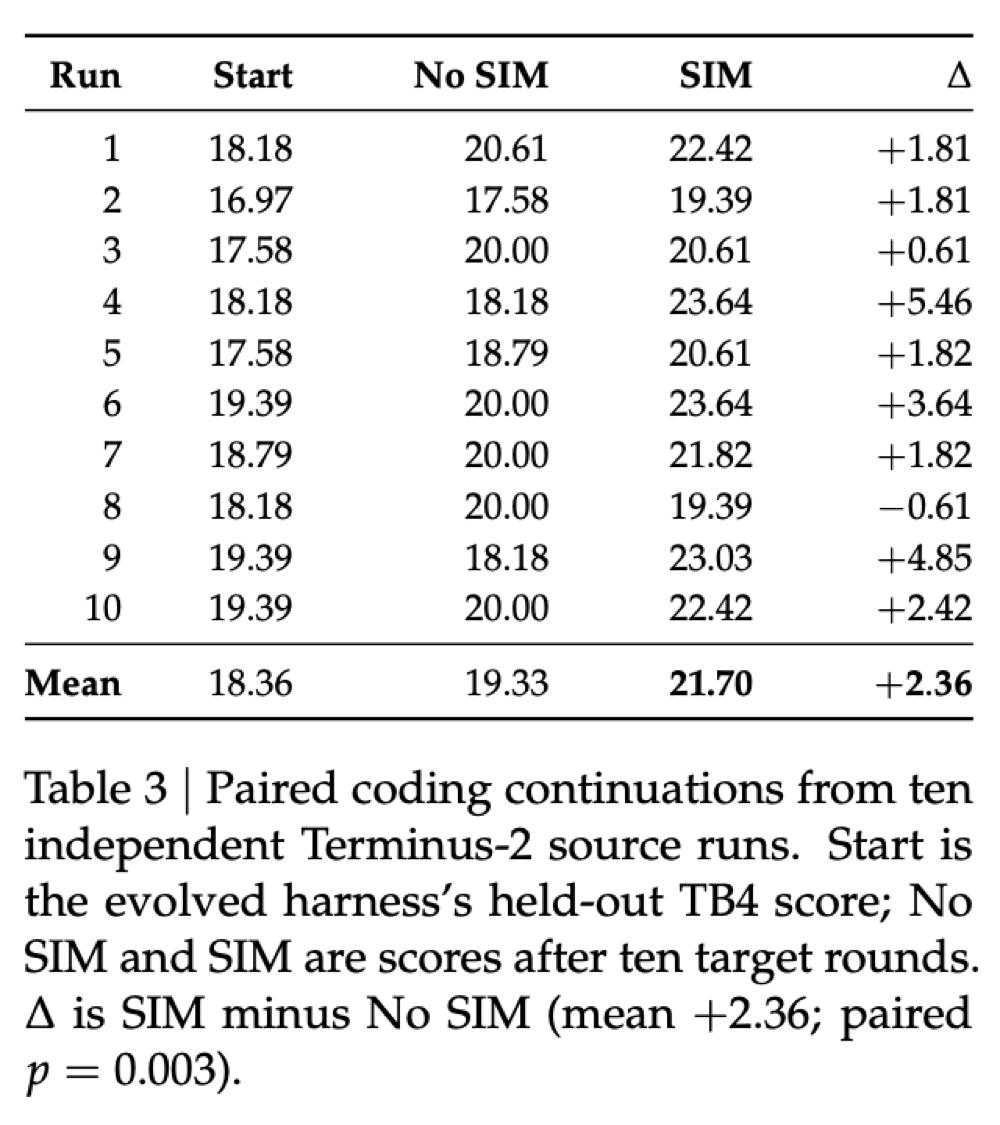
▲10组编程对照实验结果
研究团队还尝试让这套运行框架及其记忆,依次适应Gemini 2.5 Flash、Gemini 3.5 Flash、Gemini 3.8 Flash和Gemini 4 Argon。
与每一代模型从零开始优化相比,继承历史经验的方案在Gemini 3.5 Flash和Gemini 3.8 Flash上分别领先3.5分、1.6分。不过,在Gemini 4 Argon上,继承经验的方案最终得分反而落后0.8分。
这说明,历史经验虽然有助于AI跨模型继续优化,但并不保证每一次迁移都能取得更好的结果。
03.
AI能持续自我进化吗?
模型权重仍未改变
这项研究也在X上引发讨论。科技博主Superman认为,过去AI尝试自我改进时,容易忘记此前的成功经验、重复犯错,或者陷入无效的修改循环。
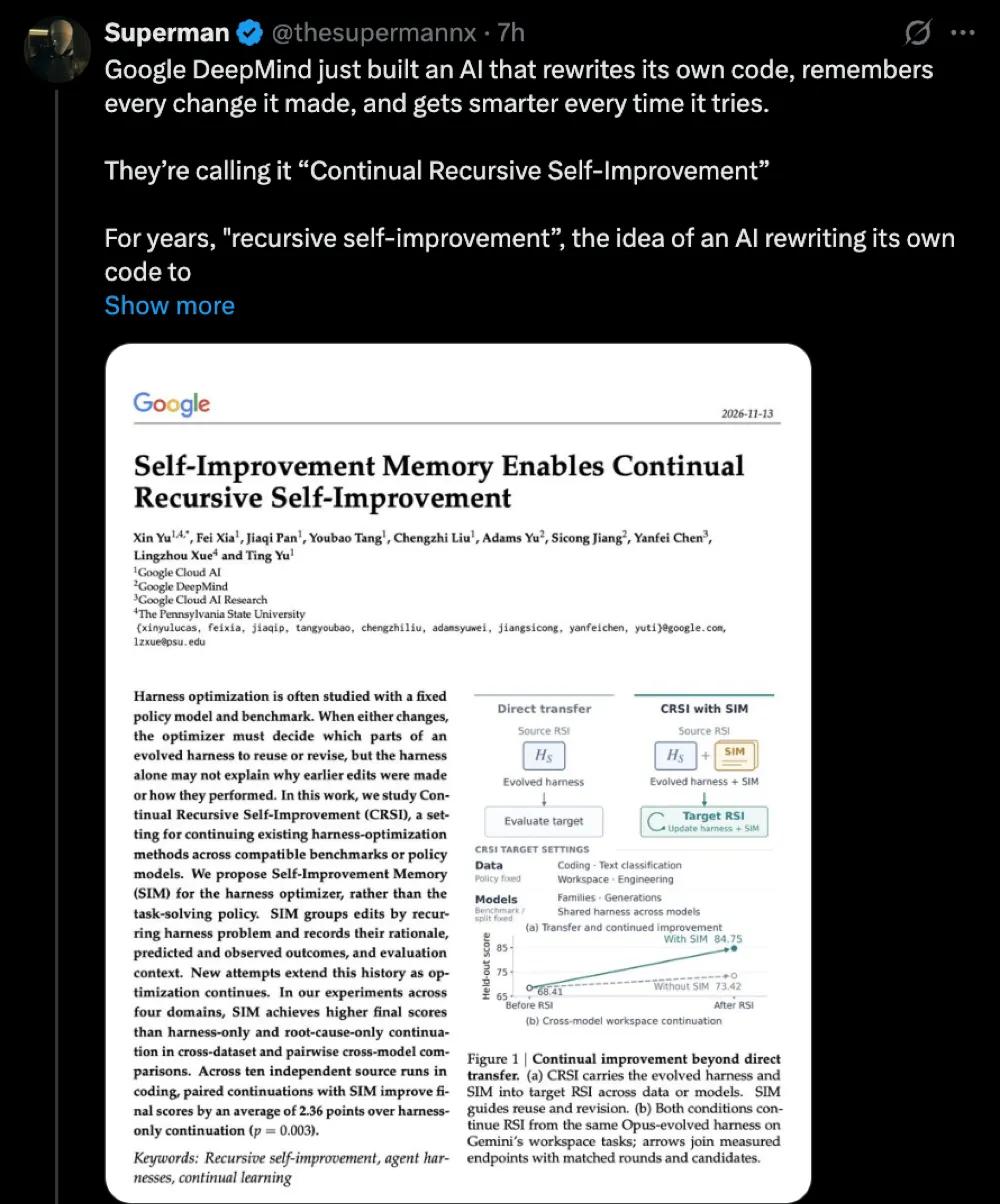
而SIM的出现,让AI可以回顾过去的修改记录,了解哪些方案有效、哪些方案失败,从而在此前的成果上继续优化。
在他看来,这让AI有机会通过不断积累经验,实现持续的递归自我改进。
这一理解与论文希望解决的问题有一定相通之处,但论文中的一部分实验说明:关于AI能够持续提升自身智能水平的说法,还需要结合实验范围来看。
另一位开发者Brian Skellenger则提醒,这项研究中的AI虽然能够自主修改代码、通过测试反馈持续优化,但修改的是大模型外部的运行框架,而不是模型自身的架构或参数。论文也明确提及,实验中大模型的权重始终保持不变。
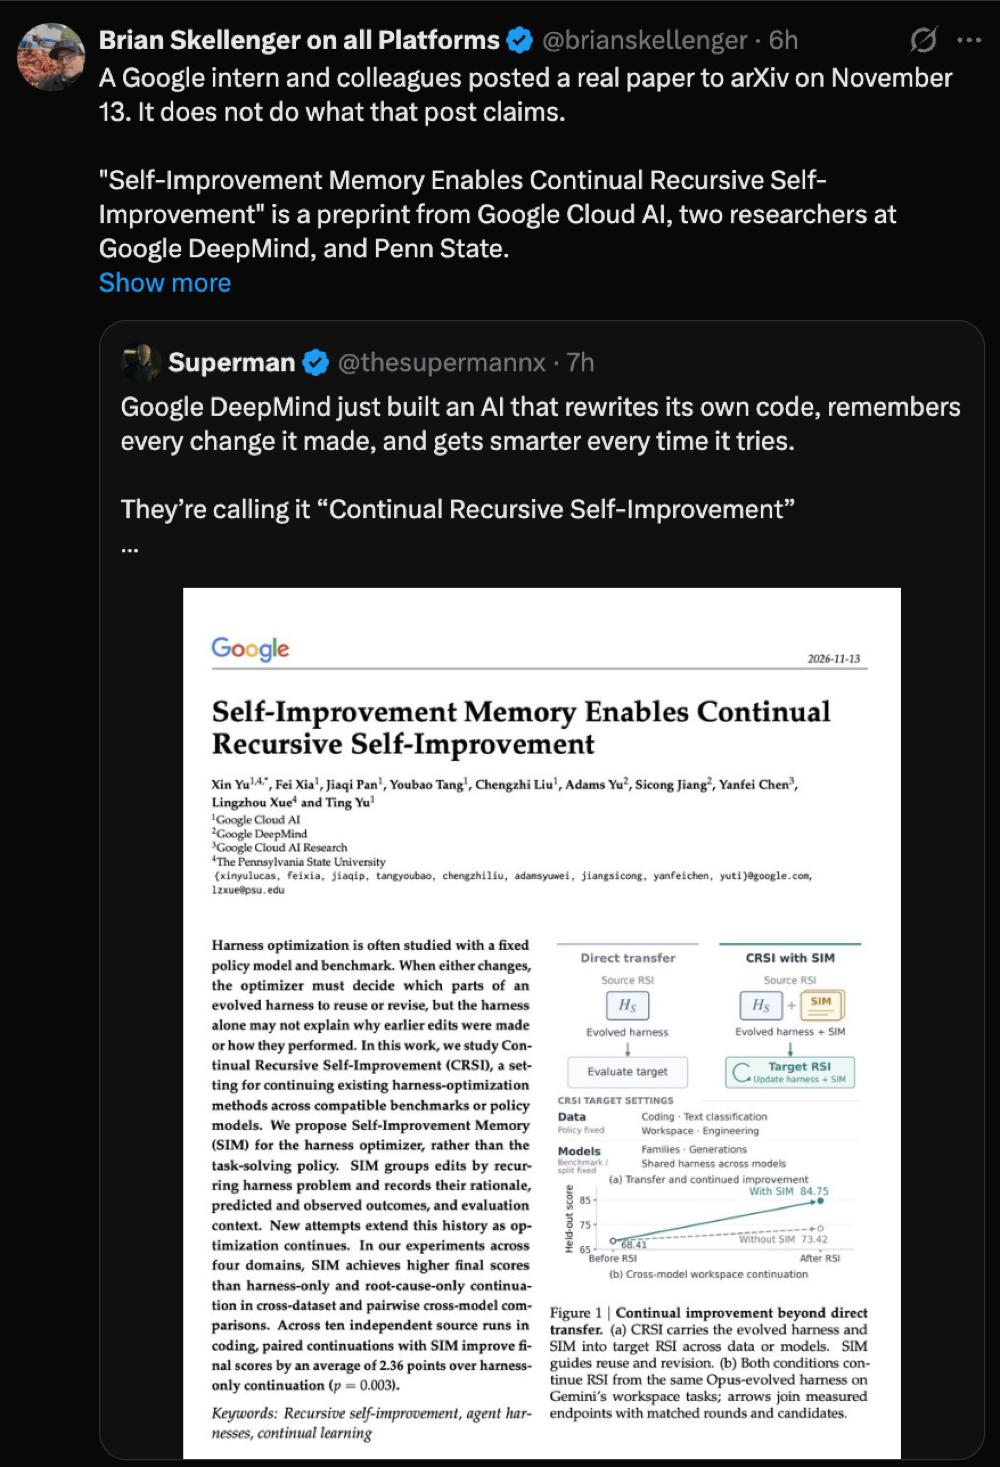
总体而言,这项研究的进展在于,让AI能够积累并复用此前的优化经验。 除了保存修改后的代码,系统还会记录每次修改的原因、预期效果和实际结果,以便在更换任务或模型后继续利用这些经验。
正如论文第一作者Xin Yu所说,AI系统需要积累的不只是优化结果,还有得到这些结果的过程。
04.
结语:AI递归自我改进
迈向持续进化
过去,递归自我改进(RSI)让AI能够通过反复修改代码、测试效果来优化自身Harness,但过去的优化成果往往难以跨模型、跨任务延续。而现在,SIM让AI不仅能继承修改后的代码,还能利用过去的成功和失败经验,将RSI延续到新的模型和任务中,为持续递归自我改进(CRSI)提供了新的方法。
不过,实验中的持续优化仍有预设的测试范围和轮次,跨模型迁移也并非总能取得更好的成绩。要让AI真正实现长期、稳定的自我进化,还需要解决如何自主判断、筛选和更新历史经验的问题。