
 搜索

1.闪迪与您相约GMIF2026,分享NAND技术创新;
2.智现未来亮相 IICIE 2026,Al深度融合,打破流程边界;
3.芯联集成与吉林大学开启战略合作,联合开发智能底盘芯片;
4.芯华章 × 中国移动|亮相 2026 中国算力大会,共建 OISA 超节点可信验证底座;
5.天玑9600 Pro性能能效双突破!携2nm工艺与AI原生架构登场;
6.美光演示全球首个在多服务器平台上的512GB DDR5模块 用于下一代服务器
1.闪迪与您相约GMIF2026,分享NAND技术创新
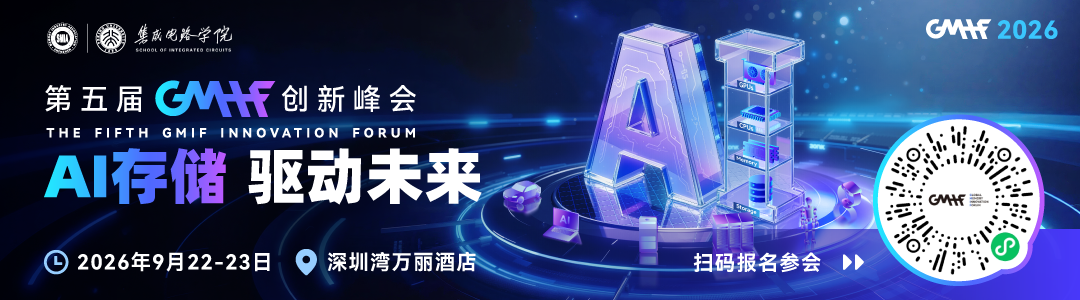
9月23日,GMIF2026全球存储器行业创新峰会将在中国·深圳湾万丽酒店举办。本届峰会以“AI存储,驱动未来”为主题,立足存储产业链,面向AI基础设施与云边端应用新场景,汇聚存储/半导体产业链与Token概念厂商、投资机构及科研院校等产业力量,共同探讨AI时代存储产业的新趋势、新需求与新合作。
随着AI从模型训练迈向大规模推理,特别是智能体(Agentic AI)带来的长上下文与海量Token生成,数据中心的存储层级正在经历一场深刻的重构。业界逐渐意识到,过去高度聚焦于高带宽内存的单一算力叙事,已无法独立支撑庞大的AI存储栈。当KV Cache膨胀至TB级,企业级SSD凭借出色的成本效益、高带宽与高可靠性,正全面承接AI推理中的“温数据层”,负责存储预训练模型权重、溢出的KV缓存及向量数据库索引。
借助CXL或NVMe-oF等前沿互联技术,云厂商甚至将企业级SSD作为扩展显存,实现近似内存的访问速度,从而大幅优化推理效率与成本结构。如今,企业级SSD及闪存产品已成为AI基础设施扩张的核心硬件,预计到2030年,该领域闪存总市场规模(TAM)将达1.2 ZB(泽字节)。
#闪迪 资深产品市场总监 #张丹 女士将出席GMIF2026,并带来《NAND:支撑AI时代规模化创新的基石》的主题演讲。张丹女士将系统阐述闪迪如何以NAND为核心,构建支撑AI规模化创新的全栈能力。不仅分享闪迪在突破NAND综合性能方面的技术探索,她还将全面解析闪迪如何精准匹配不同AI工作负载,构建起覆盖云、边、端、车的全场景AI存储解决方案,为AI基础设施的规模化落地提供坚实支撑。
9月23日,深圳湾万丽酒店
第五届GMIF2026全球存储器行业创新峰会期待您的到来,共同聆听张丹女士对NAND在AI时代战略价值的深度解读。
立即报名,锁定参会席位!
2.智现未来亮相 IICIE 2026,Al深度融合,打破流程边界
2026年9月9日至11日,IICIE 创新博览会、CIOE中国光博会、elexcon深圳国际电子展三展联动,贯通“光—芯—电”全链条,汇聚产业链5000多家企业共赴盛举。三展联动的深层逻辑,在于AI算力时代产业边界加速消融——光互连、集成电路、嵌入式系统不再是各自独立的赛道,而是同一生态中互为连接、互为支撑的环节。
这种“跨界融合”的态势,在智现未来的展台上得到了另一种维度的呼应。当前,横亘在设备、数据、工艺、良率之间的流程边界,正成为制约半导体制造效率的关键瓶颈。本届展会,智现未来携全链路Agent群亮相,不仅仅只是展示单点智能化工具,更聚焦Agentic AI全流程闭环在泛半导体制造领域的最新落地验证——以AI实现深度融合,从数据贯通再到流程闭环。
先打通:突破数据孤岛
工程数据孤岛一直是半导体制造行业的老大难问题。数据分散存储在组织内部的各类来源中,查找关键工程数据可能需要数天甚至数周的反复检索。麦肯锡研究显示,在数据存储管理混乱情况下,员工用于查找数据的时间可占工作总时长的30%-40%。而最具价值的制造与工程知识往往未被系统化地记录下来,而是以直觉和经验的形式存在于专家的脑海中。当员工在不同团队、不同部门之间调动或离职时,数据定位任务变得更为棘手。这些系统之间,需要构建一座能连接相关信息片段的统一集成层。
智现未来的解法,是以半导体垂直大模型“灵犀Lingxi”贯通全局数据、形成支撑上层智能体的数智底座——通过多模态数据聚合,将晶圆生产过程中的CP、FT、WAT、Inline、Defect等结构化数据与工艺文档、工程师经验等非结构化知识进行统一整合;同时通过API 接口对接工厂现有的MES、SPC、FDC及缺陷检测等业务系统,实时调用相关分析工具与检测设备,让设备、工艺、良率工程师在同一个智能门户中协作。
这一数据底座的搭建,为上层Agentic AI应用的流程闭环提供了坚实的数据基础与信息基础。
再闭环:跨越流程边界
数据打通解决了“看得见”的问题,流程闭环则解决“做得成”的问题。智现未来的Agentic AI的核心价值浓缩为“感知-分析- 预测-自适应&执行”的完整闭环,通过Agent之间的流转与协作,让良率问题得以快速闭环。
具体而言,“灵犀lingxi”大模型首先会接收来自工程师或上层系统的自然语言任务请求,随后通过检索工厂知识库中的相关知识条目,借助CoT推理策略对任务需求进行逐步拆解。例如,对于“异常监测”任务,智能体能够自动细化为“缺陷感知—良率分析—根因定位—修正&执行”多个子任务。
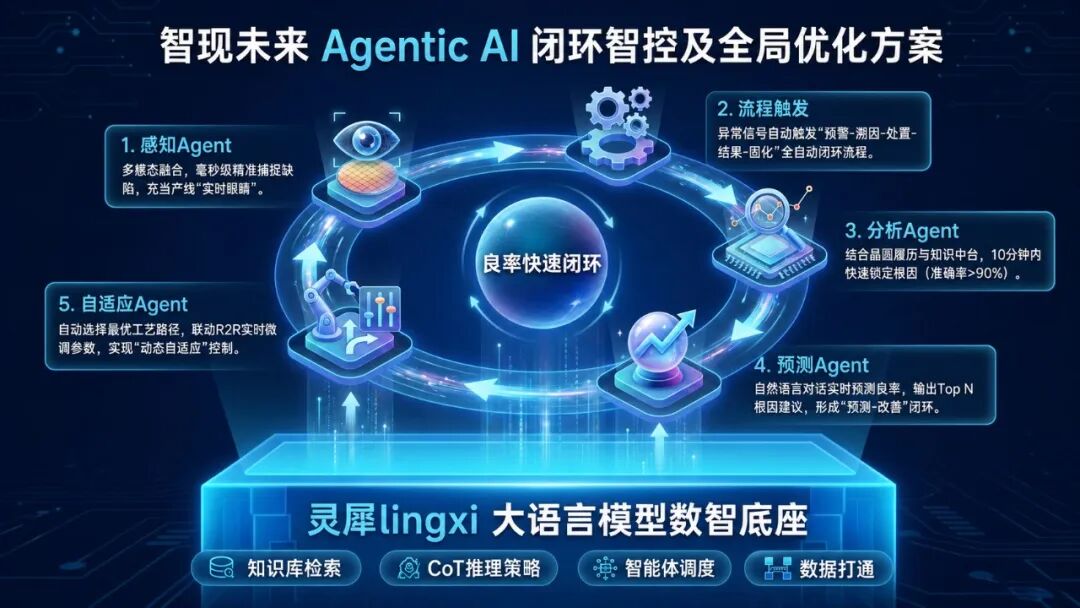
感知Agent:AIDC 多模态融合缺陷感知&识别
基于轻量化多模态大模型的实时缺陷识别,在机台侧部署覆盖视觉、光谱、传感器时序数据的轻量化 AI 模型,实现关键缺陷和物性的毫秒级识别与量化,充当系统 “实时眼睛”。产线不再是“黑盒”。任何微小的工艺偏离或缺陷萌芽,都会在第一时间被其精准捕捉。
流程触发:DN异常处置
从感知层捕捉到的异常信号,会自动触发DN系统的“实时异常报警->大模型异常溯因与处置建议->异常处置->结案报告生成->知识中台固化经验”全自动异常处置流程,推动工程师在各流程节点的快速响应,迅速完成良率问题的处置闭环。
分析Agent:基于晶圆履历分析与知识中台的多维溯因
结合履历生成&比对,以及知识中台的精准推理,可快速实现晶圆历史追溯与异常根因定位。
在某12吋晶圆厂新型异常分析应用中,“灵犀lingxi”深度挖掘历史Case价值,基于Wafer履历和过往经验,10分钟快速锁定根因(准确率超过90%),推理全程可视化可溯源,Case解决效率大幅提升60%,培训周期直降50%。
预测Agent:DLY良率预测,提供“预见未来”的能力
以自然语言对话完成Kill Ratio、Defect GDS Location实时良率预测及异常告警,精准量化每道工序的良率贡献与最终良率叠加结果。预测结果会自动关联履历溯因分析、相关性分析等工具,输出Top N根因推荐和处置建议,形成“预测—溯因—改善”闭环。
自适应Agent:最优路径优化与实时工艺参数调节
当一个批次(Lot)即将开始某工序(如刻蚀)时,系统将不再随机派工,而是向良率预测智能体模型发起提问“预测良率是多少?” ,预测智能体给出基于当前状态的精准预测。最优路径系统将自动选择“预测良率最高”的最优路径(设备/腔体),联动RTD自动派工。
最优路径解决了“机台组合爆炸”的全局优化难题,紧接着R2R(先进过程控制)发挥“工艺漂移”的实时修正作用,对重点工艺参数(如 CVD 中的压强、温度、气体流量)进行自动、微小的补偿性调节。两者协同控制,将工艺控制从“静态配方”带入“动态自适应”时代,将质量波动实时扼杀在萌芽状态。
以上方案是智现未来Agentic AI 闭环智控及全局优化方案的集中体现,也是YES 全链路智能良率提升平台的核心。它打破了传统模式下感知、报警、分析、预测、执行各系统各自为战的格局,以“灵犀lingxi”大模型为调度中枢,让Agent在“感知—分析—预测—自适应”链路中自主流转,打破数据孤岛、信息孤岛、功能孤岛,实现全流程的自主化闭环。
当前该方案已在12吋先进晶圆厂落地验证,帮助客户在效率、成本、良率与工艺稳定性等方面实现整体优化与智能化升级
全域融合、智能闭环,已成大势。IDC相关报告提出,企业级AI Agent的核心价值在于大模型调度能力与全链路自动化闭环,推动企业从“流程提效”向“决策智能化”跃迁。而半导体制造与智能体的持续融合进阶,离不开产业链的深度合作。智现未来愿以开放姿态,与更多晶圆厂、设备商及AI伙伴协同,在AI赋能半导体制造道路上持续探索,共同推动AI半导体全链路智造从愿景走向现实。
3.芯联集成与吉林大学开启战略合作,联合开发智能底盘芯片
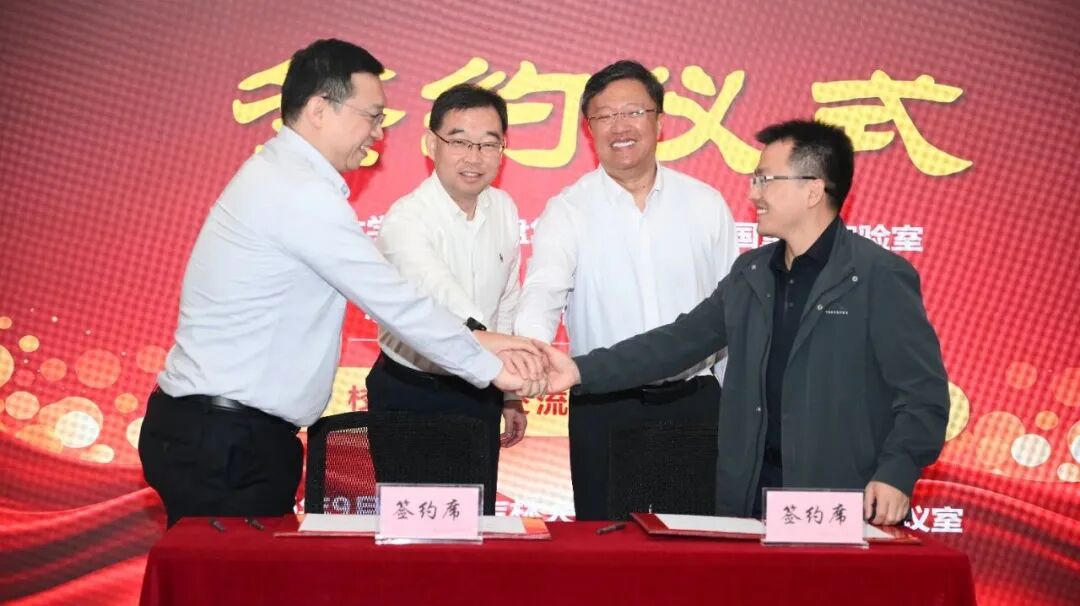
9月11日,芯联集成(688469.SH)与吉林大学汽车底盘集成与仿生全国重点实验室签署战略合作协议,以校企协同创新推动汽车底盘技术与国产芯片深度融合,加速国产芯片在智能底盘领域的产业化落地。
芯联集成董事长、总经理赵奇,中国工程院院士、吉林大学汽车学科带头人郭孔辉等校企双方代表共同出席签约仪式,并为“底盘芯片联合开发实验室”揭牌。
一汽、蔚来、中车电驱等车企代表一同见证。
智能底盘是高阶智能驾驶的核心执行载体与安全底座。伴随L2及以上智驾车型的快速渗透,底盘电动化、线控化、智能化成为产业升级的核心方向。
本次校企合作将打通产业平台与前沿科研的通道,为汽车智能化发展探索更多可能性。
4.芯华章 × 中国移动|亮相 2026 中国算力大会,共建 OISA 超节点可信验证底座
9 月 11-13 日,2026 中国算力大会在河北廊坊举办。作为国家级算力产业交流合作平台,大会紧扣算力网纳入国家 “六张网” 建设的战略部署,汇聚算力全产业链,集中展示算力基础设施的前沿成果。
超节点是新一代AIDC的基础算力供给单元,通过机柜级系统协同缓解通信、内存和功耗瓶颈,支撑万亿参数大模型及万卡/十万卡级大规模集群,推动AIDC从“服务器堆砌”转向机柜级一体化系统工程。端到端的系统验证,也成为超节点研发与落地的关键基础。
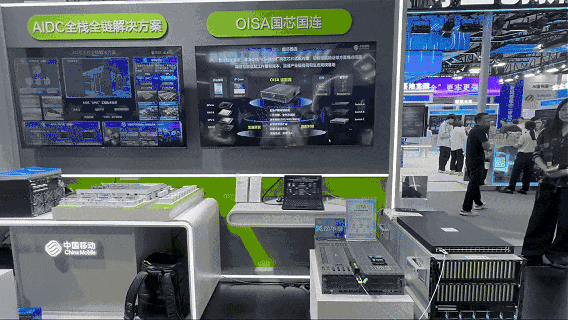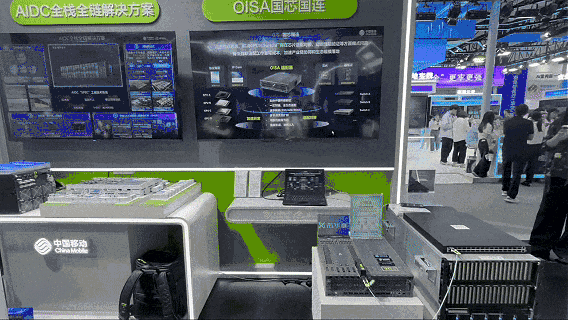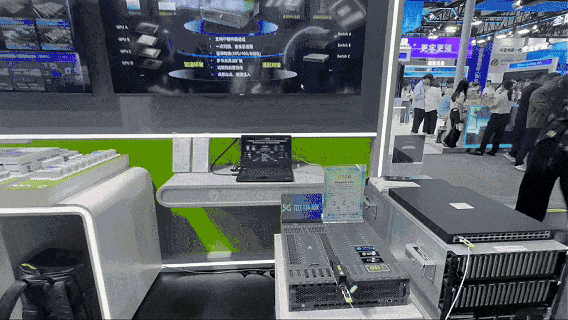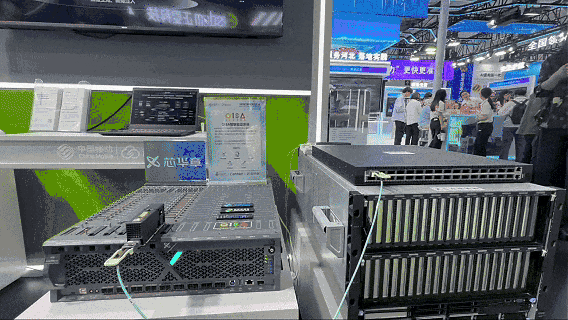
在本届算力大会展区,芯华章与中国移动联合展出“OISA国芯国连”系统,构建面向OISA协议的计算芯片、交换芯片及互联系统端到端验证闭环,降低超节点多类型芯片接入、互联适配与系统集成门槛,为智算超节点的技术研发、系统集成和生态协同提供提供关键验证环境。
展出期间,系统吸引了众多行业专家及产业链伙伴驻足观摩与深入交流。
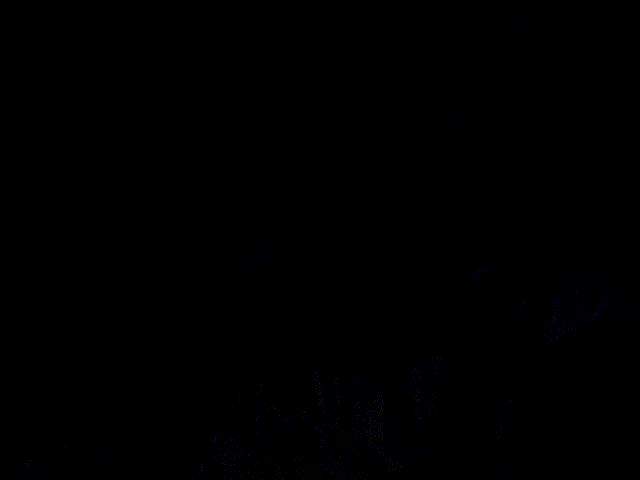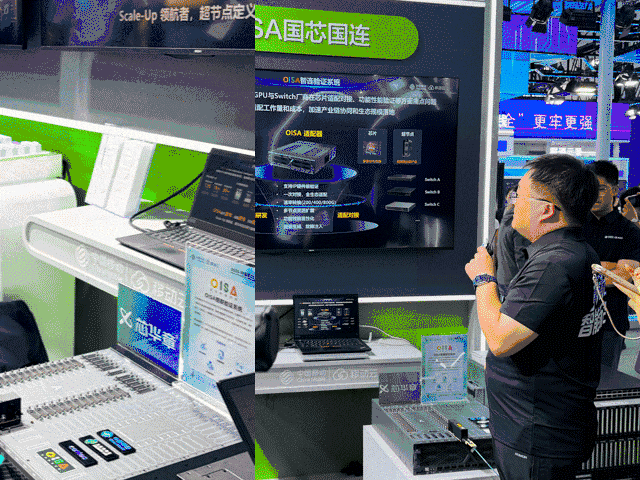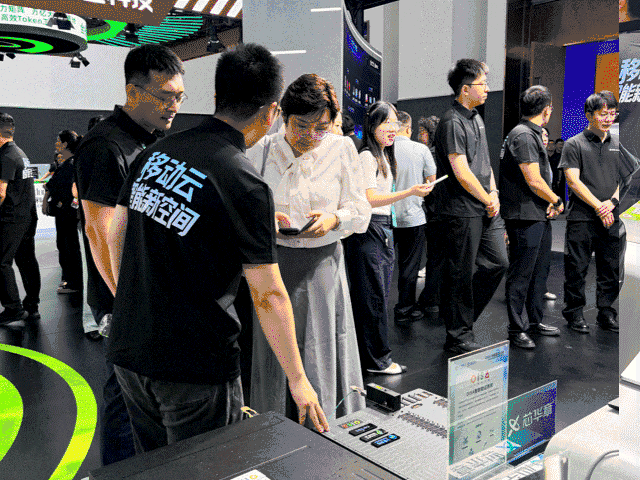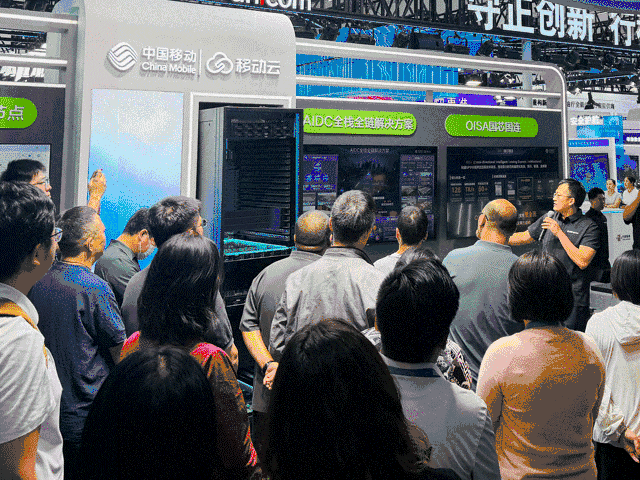
图:中国算力大会OISA国芯国连系统现场
一、超节点演进带来系统级验证挑战
随着大模型规模持续增长和算力需求快速提升,智算基础设施正加速向高密度、高带宽、低时延的超节点架构演进。
超节点并非计算芯片的简单堆叠,其整体性能、扩展能力与系统可靠性高度依赖GPU、CPU、网络交换等环节的协同设计与高效互联。
OISA(Omni-directional Intelligent Sensing Express Architecture,全向智感互联架构)是由中国移动牵头打造的Scale-up互联开放协议,面向智算超节点高速互联需求,推动构建开放、自主、高性能的智算互联技术体系,降低不同计算芯片与交换设备之间的互联适配门槛,为超节点规模化算力连接及产业生态协同提供统一的互联技术基础。
在超节点系统研发过程中,异构芯片互联、多厂商设备组网以及协议一致性验证,是产业协同面料的重要技术挑战。
传统验证方式往往难以实现芯片仿真环境、真实交换设备与物理加速硬件之间的端到端贯通,存在可验证组网场景有限、原型构建成本较高、跨厂商系统联调周期较长等问题。
如何建立覆盖芯片、协议、交换及整机系统的统一验证环境,已成为提升超节点Scale-up技术研发、适配验证和生态迭代效率的重要基础。
二、打通仿真环境与真实设备
针对这些挑战,芯华章面向OISA协议打造速度匹配与系统级仿真验证能力,为超节点关键芯片、互联协议与交换设备的协同验证提供重要技术支撑。
作为连接硬件仿真加速平台与真实物理交换设备的关键枢纽,该设备全面适配OISA协议体系,实现仿真环境与真实硬件之间的速率适配、报文转发和协议透传,并支持链路重传、无损流控等关键机制,有效贯通“虚拟芯片—互联协议—真实交换系统”的端到端验证链路,提升仿真验证与真实系统运行的一致性,为OISA生态的芯片研发、协议验证和系统联调提供高效、可靠的验证基础。
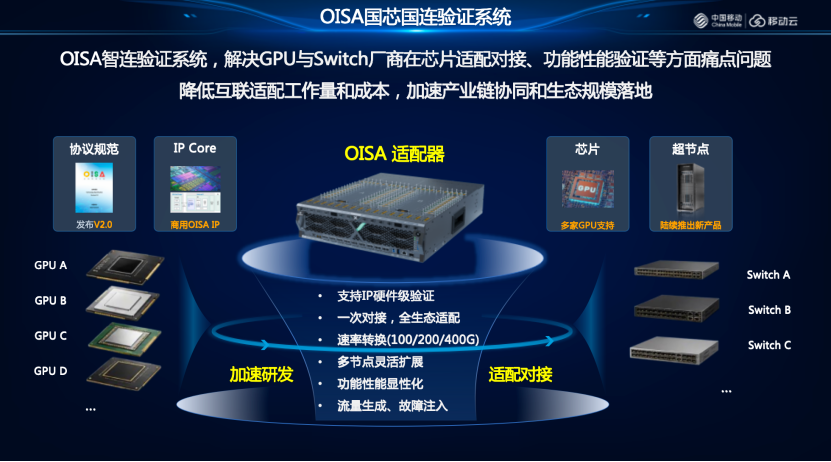
图:OISA国芯国连验证系统
本次联合展示了GPU 超节点互联场景,借助速度转换桥,芯华章硬件仿真加速平台可以直连真实交换机,并对接物理 GPU 硬件,搭建高度贴近真实部署的超节点仿真验证环境。该方案支持多重组网模式:
单台仿真加速平台通过转换桥直连物理交换机,完成基础组网调试;
对接真实 GPU 设备,构建端到端 GPU 超节点仿真互联环境;
多台仿真加速平台同时接入同一台物理交换机,开展大规模超节点集群组网验证。
未来,方案还将进一步覆盖 CPU/GPU 异构互联、GPU-Switch-Tester 等复杂的场景,不断拓展智算仿真的能力边界。
中国移动现场讲解专家表示:
“推动OISA真正走向产业落地,靠的不是某一个环节单点突破,而是协议、芯片、交换设备、整机系统和验证工具的协同推进。
这次我们和芯华章联合展示超节点仿真验证方案,就是希望进一步打通从协议实现、芯片适配到系统组网和整机验证的完整链路,为产业伙伴开展芯片接入、设备互通和超节点系统验证提供更高效、更可靠的技术支撑,也进一步推动OISA生态向更加开放、协同和成熟的方向发展。”
芯华章科技解决方案专家表示:
“超节点是下一代智算集群的核心架构,开放互联协议 + 可信验证体系,是生态壮大的两大支柱。非常荣幸能作为中国移动 OISA 生态合作伙伴,在国家级算力大会上联合展示这套验证方案。
芯华章将持续发挥硬件仿真、系统级可信验证的技术优势,向 OISA 产业社区开放验证基础设施,助力国产芯片与交换设备高效互通,共建自主可控的算力互联生态。”
芯华章坚持以可信验证赋能集成电路产业创新,面向智算超节点、算力网络等前沿领域,芯华章将继续深化与中国移动及OISA生态伙伴的协同创新,持续完善系统级验证解决方案,为国产算力基础设施的安全可靠建设与高效创新提供坚实支撑。
5.天玑9600 Pro性能能效双突破!携2nm工艺与AI原生架构登场
9月15日,联发科(MediaTek)正式发布其新一代旗舰5G智能体AI芯片——天玑9600 Pro与天玑9600M,这两款芯片以全新的AI原生架构和台积电2nm先进制程为核心,旨在重构旗舰智能手机的性能、能效与智能化体验。
天玑9600 Pro:2nm定义旗舰性能新高度
天玑9600 Pro采用台积电2nm制造工艺,并经由联发科与台积电的设计工艺协同优化,实现了性能与能效的双重飞跃。
CPU方面,天玑9600 Pro采用创新的2+3+3全大核架构,包含2个主频高达4.55GHz的C2-Ultra超大核、3个主频为4.35GHz的C2-Pro大核以及3个主频为3.1GHz的C2-Pro大核。配合34.5MB的超大容量缓存架构(L2+L3+SLC),并率先支持LPDDR6内存和UFS 5.0闪存,其单核性能较上一代提升17%,多核性能提升15%,而在峰值性能下的多核功耗则大幅节省61%。
GPU方面,天玑9600 Pro搭载的旗舰G2-Ultra NX GPU峰值性能提升27%,功耗在峰值性能下节省24%,光线追踪性能提升18%。芯片支持185帧超高帧率游戏,并率先落地Ray Tracing Pipeline技术,结合第三代光线追踪引擎和天玑OMM光追硬件加速技术,将主机级游戏体验带入移动平台。
天玑9600 Pro的核心突破在于其AI原生架构,通过天玑智算融合架构将CPU与NPU深度协同,并升级了天玑调度引擎,以精准调动系统资源。
芯片集成了强大的双NPU架构和智能体化AI引擎。其中,第二代超能效NPU融合低功耗传感器中枢,功耗相较上一代节省40%,为设备提供全时感知能力。而超性能NPU 1090则面向复杂端侧AI应用,大语言模型预填充性能提升51%,每瓦特生成词元数至高可提升55%。
此外,新一代生成式AI引擎3.0的INT4运算能力翻倍,并支持Hybrid Attention运算和新一代大模型压缩技术,可支持高达30B的MoE混合专家模型在端侧运行。联发科还推出了天玑AI智能体化引擎3.0,旨在与生态伙伴共同打造更智能、更实用的用户体验。
在影像方面,天玑9600 Pro集成Imagiq 1290图像处理器,通过ISP与NPU的融合计算,支持全景深计算光学影像技术和60fps专业运动级追焦技术。视频录制能力也得到显著增强,率先支持4K240原生直出超高速慢动作录影,并支持CSISP 4K60电影级视频直出和微单级17EV高动态影像技术。
连接与显示等特性方面,天玑9600 Pro支持多帧OverDrive面板响应补偿技术,官方称可在1nit极暗屏下保持动态清晰;支持全链路BT.2020规格,可视色彩丰富度较DCI-P3提升38%;支持新一代H.266硬件解码,功耗较VCC软解码最多节省23%。通信方面,该芯片还提供天玑AI蜂窝选网技术2.0、天玑AI Wi-Fi速率调校技术、天玑AI定位技术2.0、前沿漫游信号共享技术以及先进蓝牙连接技术。
天玑9600M:普及旗舰体验
一同发布的天玑9600M芯片,旨在将旗舰体验普及至更广泛的市场。它承袭了天玑家族的高能效特性,融合了影像引擎、天玑AI智能体化引擎3.0、天玑调度引擎以及星速引擎等关键技术,为用户提供出色的影像、AI、游戏和通信体验。
据悉,首批搭载天玑9600 Pro和天玑9600M芯片的智能手机预计将于近期上市。
6.美光演示全球首个在多服务器平台上的512GB DDR5模块 用于下一代服务器
据美光官网消息,美光演示全球首款512GB DDR5 RDIMM内存模块,预计2027年下半年实现量产。Micron 512GB RDIMM的性能可比256GB DDR5配置高达1.4倍。AMD和英特尔都在积极验证该模块,预计其速度将达到9200MT/s。
该模块的高容量得益于美光先进的垂直互连封装技术。该产品采用垂直堆叠的方式,通过硅通孔 (TSV) 互连 DRAM 芯片,从而在保证现代数据中心架构所需性能的同时,最大限度地提高单个 DRAM 封装内的密度。该模块可在单个 24 插槽双路服务器中实现高达 12TB 的 DDR5 DRAM 容量。