
 搜索

1. 奕斯伟计算与SiFive签署黄金合作伙伴联盟MOU 深化RISC-V +AI技术与产业生态合作
2. 为旌科技端侧AI芯片应用之网络摄像机(IPC)将亮相北京安博会
3. 台积电vs三星:2nm客户争夺战的“时间差”
4. 韩国10月前20天半导体出口额激增222.5%至275亿美元
5. 英伟达斩获Modal订单,Vera CPU撬动数据中心算力格局
1. 奕斯伟计算与SiFive签署黄金合作伙伴联盟MOU 深化RISC-V +AI技术与产业生态合作
近日,奕斯伟计算与国际知名的 RISC-V 处理器 IP 企业SiFive正式签署黄金合作伙伴联盟备忘录(Gold Partner Alliance Memorandum of Understanding)。本次合作是 RISC-V 产业发展进程中的重要里程碑,实现了产业链两大核心领导者的强强联合。
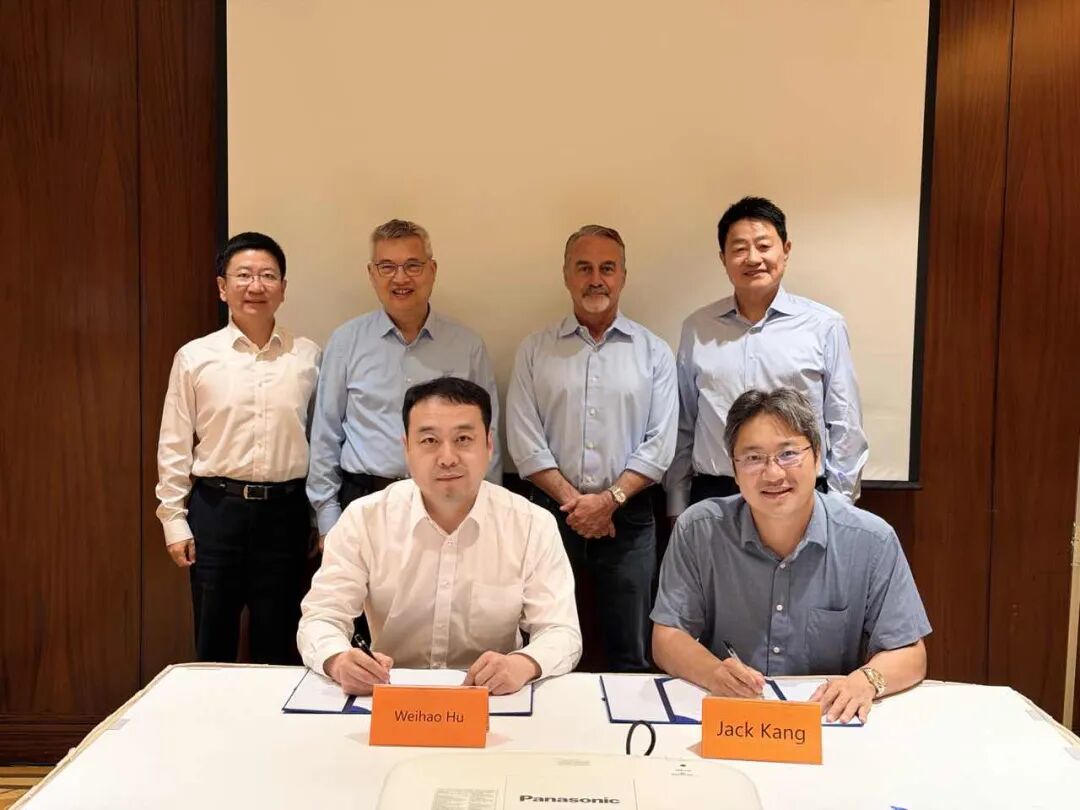
SiFive 具备 RISC-V 底层架构与内核技术创新优势,奕斯伟计算拥有行业领先的 RISC-V 产品落地与商业化能力。双方优势互补,预期将展开合作,加速 RISC-V 架构从智能边缘到数据中心基础设施及 Agentic 应用的产业化与规模化落地。双方计划在既有合作基础上,将合作从边缘 AI 进一步拓展至 Agentic AI 等应用领域。此次签约也是奕斯伟计算登陆港股后推进的一项重要国际产业合作。
SiFive 由 RISC-V 指令集架构创始团队成员创立,是全球商用 RISC-V 处理器内核领域的标杆企业,推动 RISC-V 内核在边缘、服务器和 AI 场景落地。双方拥有深厚的长期合作基础,奕斯伟计算EIC7700 SoC 已用于 SiFive 旗舰开发板 HiFive Premier P550,面向全球开发者提供高性能 RISC-V 硬件平台,并已实现规模化推向市场,验证了双方技术协同的落地能力。
双方将共同挖掘对未来低功耗、高性能 AI 解决方案的需求,包括满足 Agentic AI 等应用场景的需求。同时,结合客户不同的集成诉求,探索多层级 RISC-V 产品方案,共同推动 RISC-V 生态建设。
作为 RISC-V 芯片产品提供商,奕斯伟计算将持续联合全球产业伙伴推进 RISC‑V 芯片产品与方案的落地。此次与 SiFive 升级为黄金伙伴联盟关系,将进一步深化双方在更多领域、更多形态的产品合作。依托 SiFive 在架构底层的创新积淀与奕斯伟计算丰富的产品与方案落地能力,将为客户打通从架构创新到商业化落地的通路,加快 RISC-V 抓住 Agentic AI 等新兴应用场景带来的算力变革机遇,共同推动下一代开放计算的发展方向,助力全球计算架构生态迈向更多元、更开放的全新阶段。
2. 为旌科技端侧AI芯片应用之网络摄像机(IPC)将亮相北京安博会
11月3日 北京安博会
为旌科技诚邀您莅临
更多端侧AI应用方案
现场一睹为快!(来源: 为旌科技)
3. 台积电vs三星:2nm客户争夺战的“时间差”
三星2nm工艺尚未与主要客户敲定量产合同,4nm产线却已近满载,公司转而力推5nm订单;台积电2nm已于2025年四季度量产,已确认15家客户,苹果锁定过半初期产能,月产能年底冲刺12万片。良率爬坡、产能节奏与客户结构上的三重时间差,正在左右这场2nm客户争夺战的天平。
核心观点
1. 时间差客观存在,且比想象中更长。 台积电2nm已完成“量产、扩产、客户锁定”的完整闭环,苹果一家锁定过半初期产能;三星2nm至今没有一纸落定的大额量产合同,两家之间隔着的不是一个制程节点,而是一整条可被验证的量产证据链。
2. “谈判慢”首先是验证问题。 代工客户在量产前必须完成良率、能效、知识产权兼容性与制造稳定性的成套评估,而三星2nm良率距业界共识的70%量产门槛仍有差距,大规模量产记录尚未建立,评估周期因此被进一步拉长。
3. 客户观望同样是理性选择。 台积电产能虽已爆满,但2027年扩产路径明确,4nm与5nm又提供了性能与成本的中间选项,“双供应链”策略给了客户等待的底气。
4. 三星的破局点未必在2nm本身。 用泰勒厂的地缘价值与更激进的报价换取“第二供应商”身位,可能比正面争夺订单更现实:泰勒厂规划产能尚未投产已被预订一空,正是这一逻辑的预演。
同一个2nm,两种时间表
把两家公司的2nm并排放在一起,差距会自己说话。台积电的N2已于2025年第四季度正式进入大规模量产,采用第一代GAAnm片晶体管架构,相比3nm速度提升8%至10%、功耗降低15%至20%、逻辑密度提升约10%。进入2026年,其2nm月产能爬升至8万片,苹果一家就预订了过半产能,用于iPhone 18系列芯片。到了三季度,客户追单仍在加码:苹果、英伟达、AMD、高通、联发科在原有订单基础上追加10%至20%,台积电顺势把年底2nm月产能目标从市场预期的9万至10万片上调到12万片。
三星的时间表则要“柔软"”多。据韩媒《朝鲜商业》(ChosunBiz)报道,2nm生产合同的谈判进展慢于预期,至今尚未与全球主要科技公司达成最终合同。从技术路线看,三星同样握有GAA这张牌:2nm工艺延续了3nm世代首次商用的环栅晶体管架构,理论上具备能效与性能的上升空间。但纸面架构与量产证据之间,隔着客户一套完整的尽调流程,良率、能效、知识产权兼容性与制造稳定性,任何一项不过关,合同就只能停留在“洽谈”二字上。
对比维度 | 台积电 | 三星 |
2nm量产时间 | 2025年四季度已量产 | 泰勒厂计划2026年下半年量产,官方口径指向2027年爬坡 |
已确认客户 | 15家,其中10家为HPC客户 | 无公开大额最终合同,特斯拉、博通等处于意向洽谈阶段 |
月产能 | 2026年8万片,年底冲刺12万片 | 泰勒厂初期目标5万片 |
2nm良率 | 官方口径“良好”,爬坡顺利 | 约60%上下;9月传闻已达80%区间,未经独立验证 |
报价策略 | 产能紧张,价格坚挺 | 2nm晶圆报价约2万美元,较台积电低约33% |
近期财务支撑 | 2nm满产满销 | 4nm近满载、5nm抢单,下半年利用率目标100% |
良率:谈判桌下那只看不见的手
对代工客户来说,良率不是一个技术指标,而是一张进入量产谈判桌的门票。业内目前的共识是,2nm工艺的良率需要稳定在70%左右,才谈得上大规模量产合同。
沿着这条线看三星的爬坡轨迹:2025年下半年,其2nmGAA工艺良率还在20%附近徘徊;到2026年4月,已迅速拉升至50%中段;8月初,韩国媒体披露的估计值在60%上下;9月上旬,市场传出良率冲上80%区间、泰勒厂产能被特斯拉、博通、Arm预订一空的消息。如果传闻为真,三星用一年时间走完了台积电当年近两年的路,但这一数字目前没有独立验证,且“产能被预订”与“合同落定”之间仍有距离。
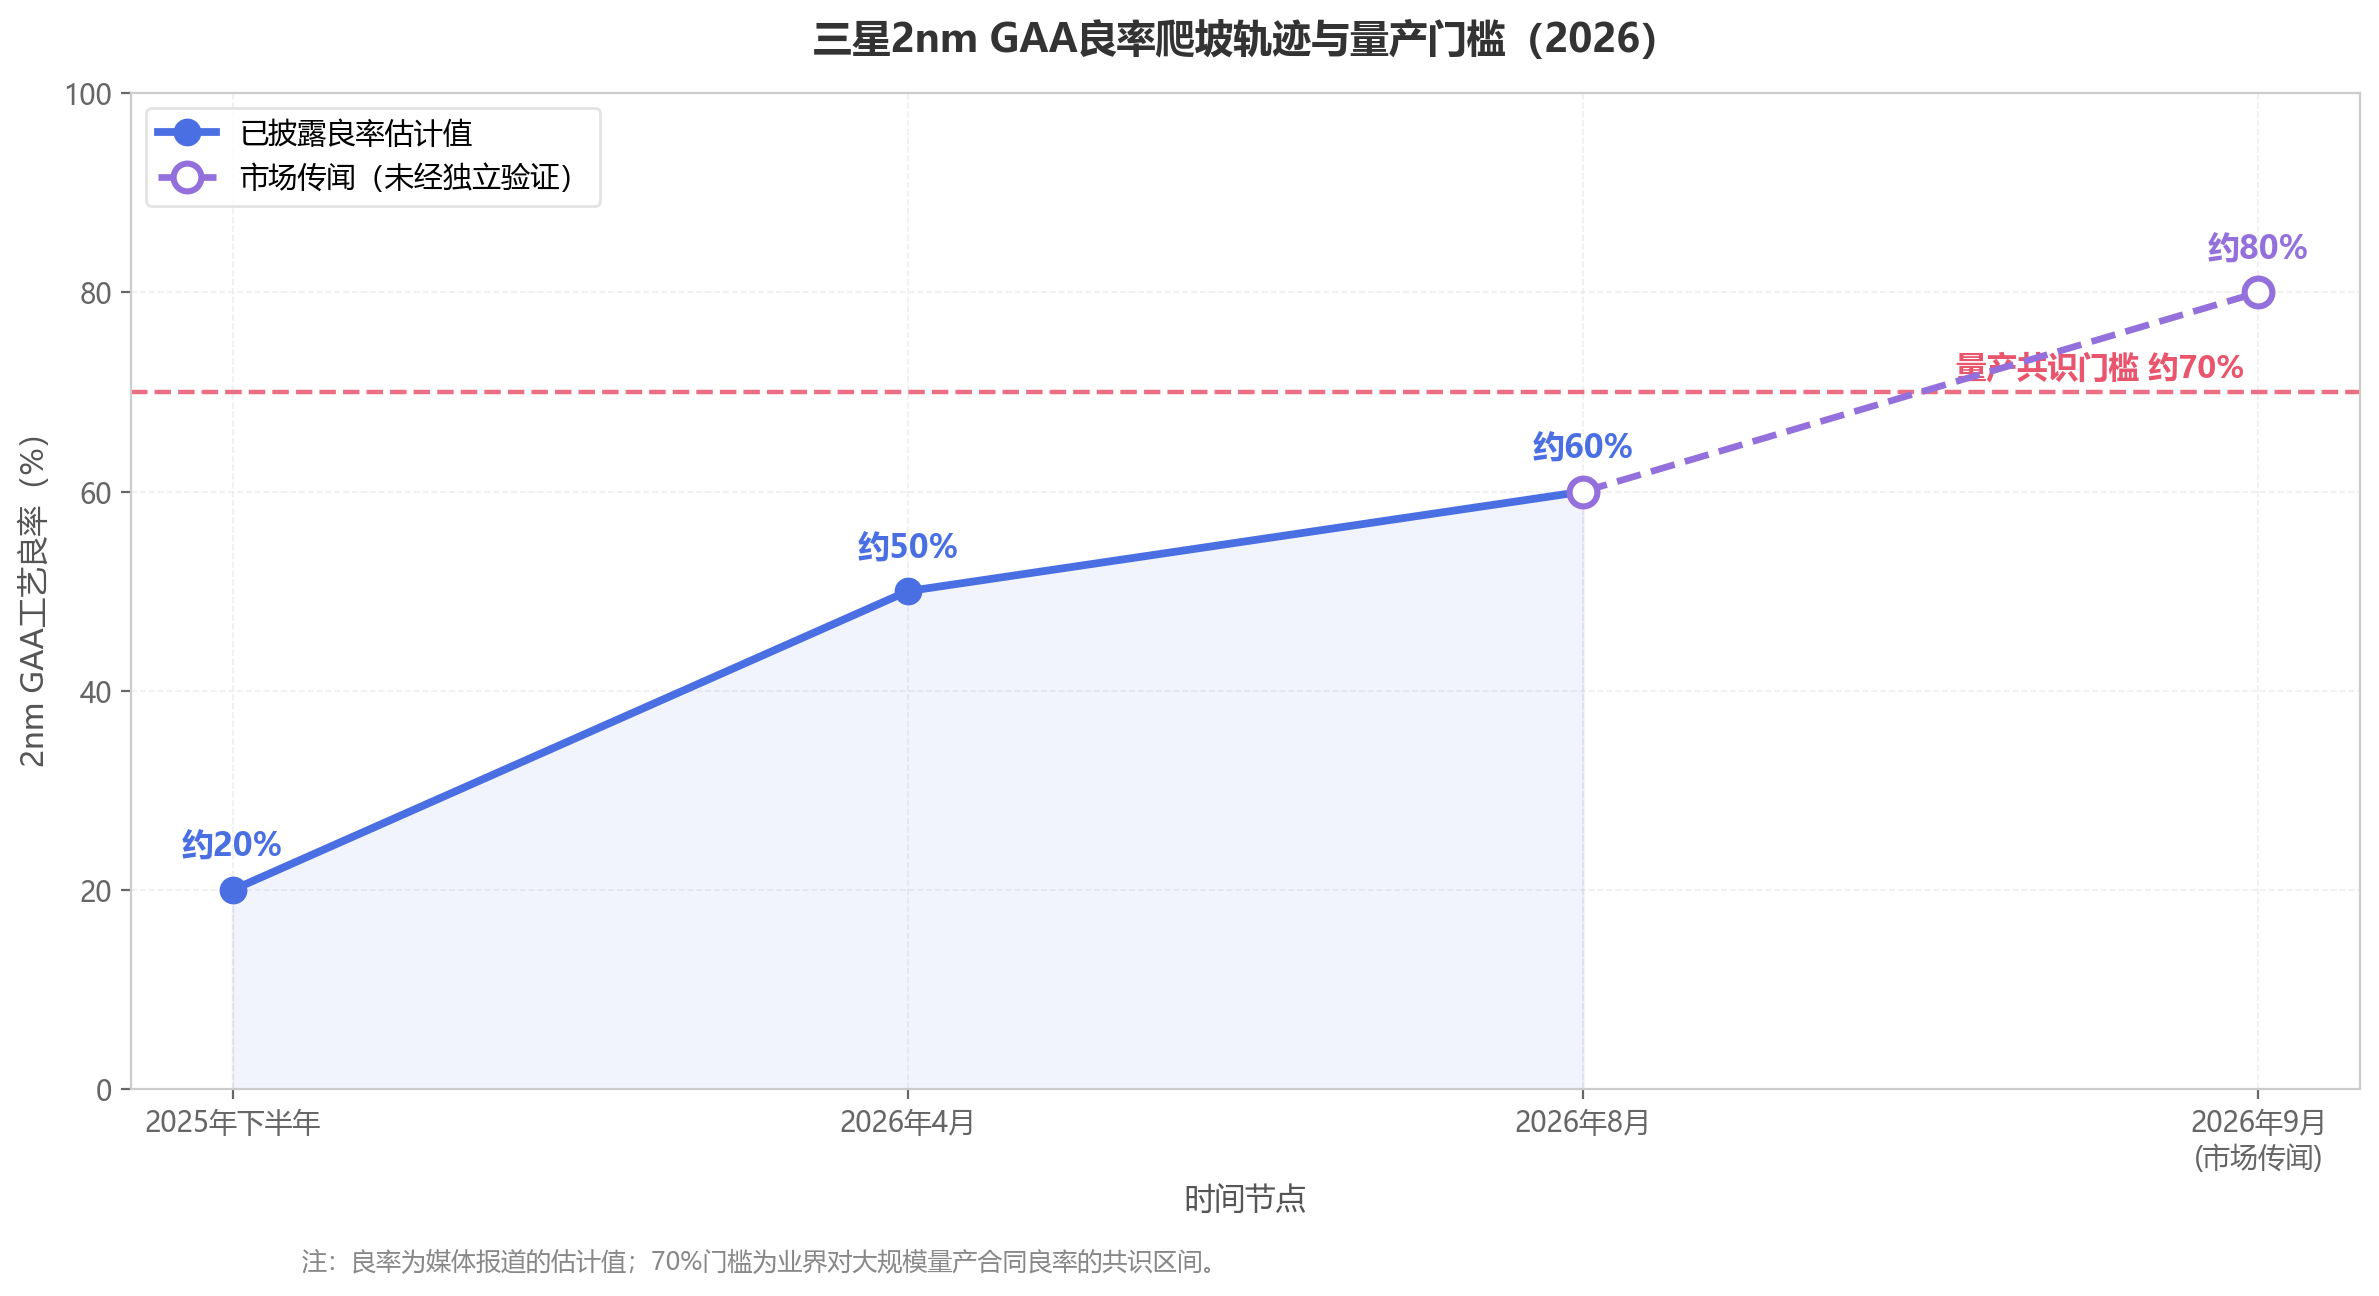
从图中可以看到,三星良率曲线陡峭,但与70%的量产共识门槛之间仍有最后一跳。这最后一跳恰恰最贵:良率从60%爬到70%以上,意味着缺陷密度、工艺窗口和量产稳定性的系统性收敛,通常需要真实量产环境的反复打磨,实验室数据替代不了。
台积电的经验数据反过来印证了爬坡的代价。N2在2023年4月同一开发阶段的256Mb SRAM测试良率刚过50%,到2024年4月才提升至80%以上,前后用了一年。换句话说,即便是代工龙头,从“能用”到“能卖”也需要以年计的打磨。三星2025年下半年才真正开始爬坡,客户把最终合同押后到良率站上门槛之后,是再自然不过的风控动作。
产能:一边爆满,一边抢跑
产能是这场时间差的另一半。台积电的2nm排产已经排到2027年,N2在新竹与高雄两地多阶段顺利爬坡,管理层给出的指引是2027年N2家族年度产能将在2026年基础上翻倍以上。需求端撑得住这个扩张:AI芯片、智能手机旗舰SoC与HPC客户同时在争夺2nm产能,2nm产能分配将面临移动客户与HPC客户之间的竞争,手机芯片厂商可能需要在产能争夺上投入更多成本。
三星的产线故事则是另一种叙事。其位于韩国平泽的4nm产线自2025年底以来保持100%的满载运转,且已获得覆盖2027年产能的4nm订单(ZDNet韩国2026年年中报道);背后的需求引擎是HBM4基底裸片,HBM4采用4nm工艺,存储市场的超级繁荣直接转化为代工产能利用率。整个代工事业的产能利用率从2024年以来长期低于50%的谷底,回升至70%至80%,三星把2026年下半年100%的利用率设为目标。
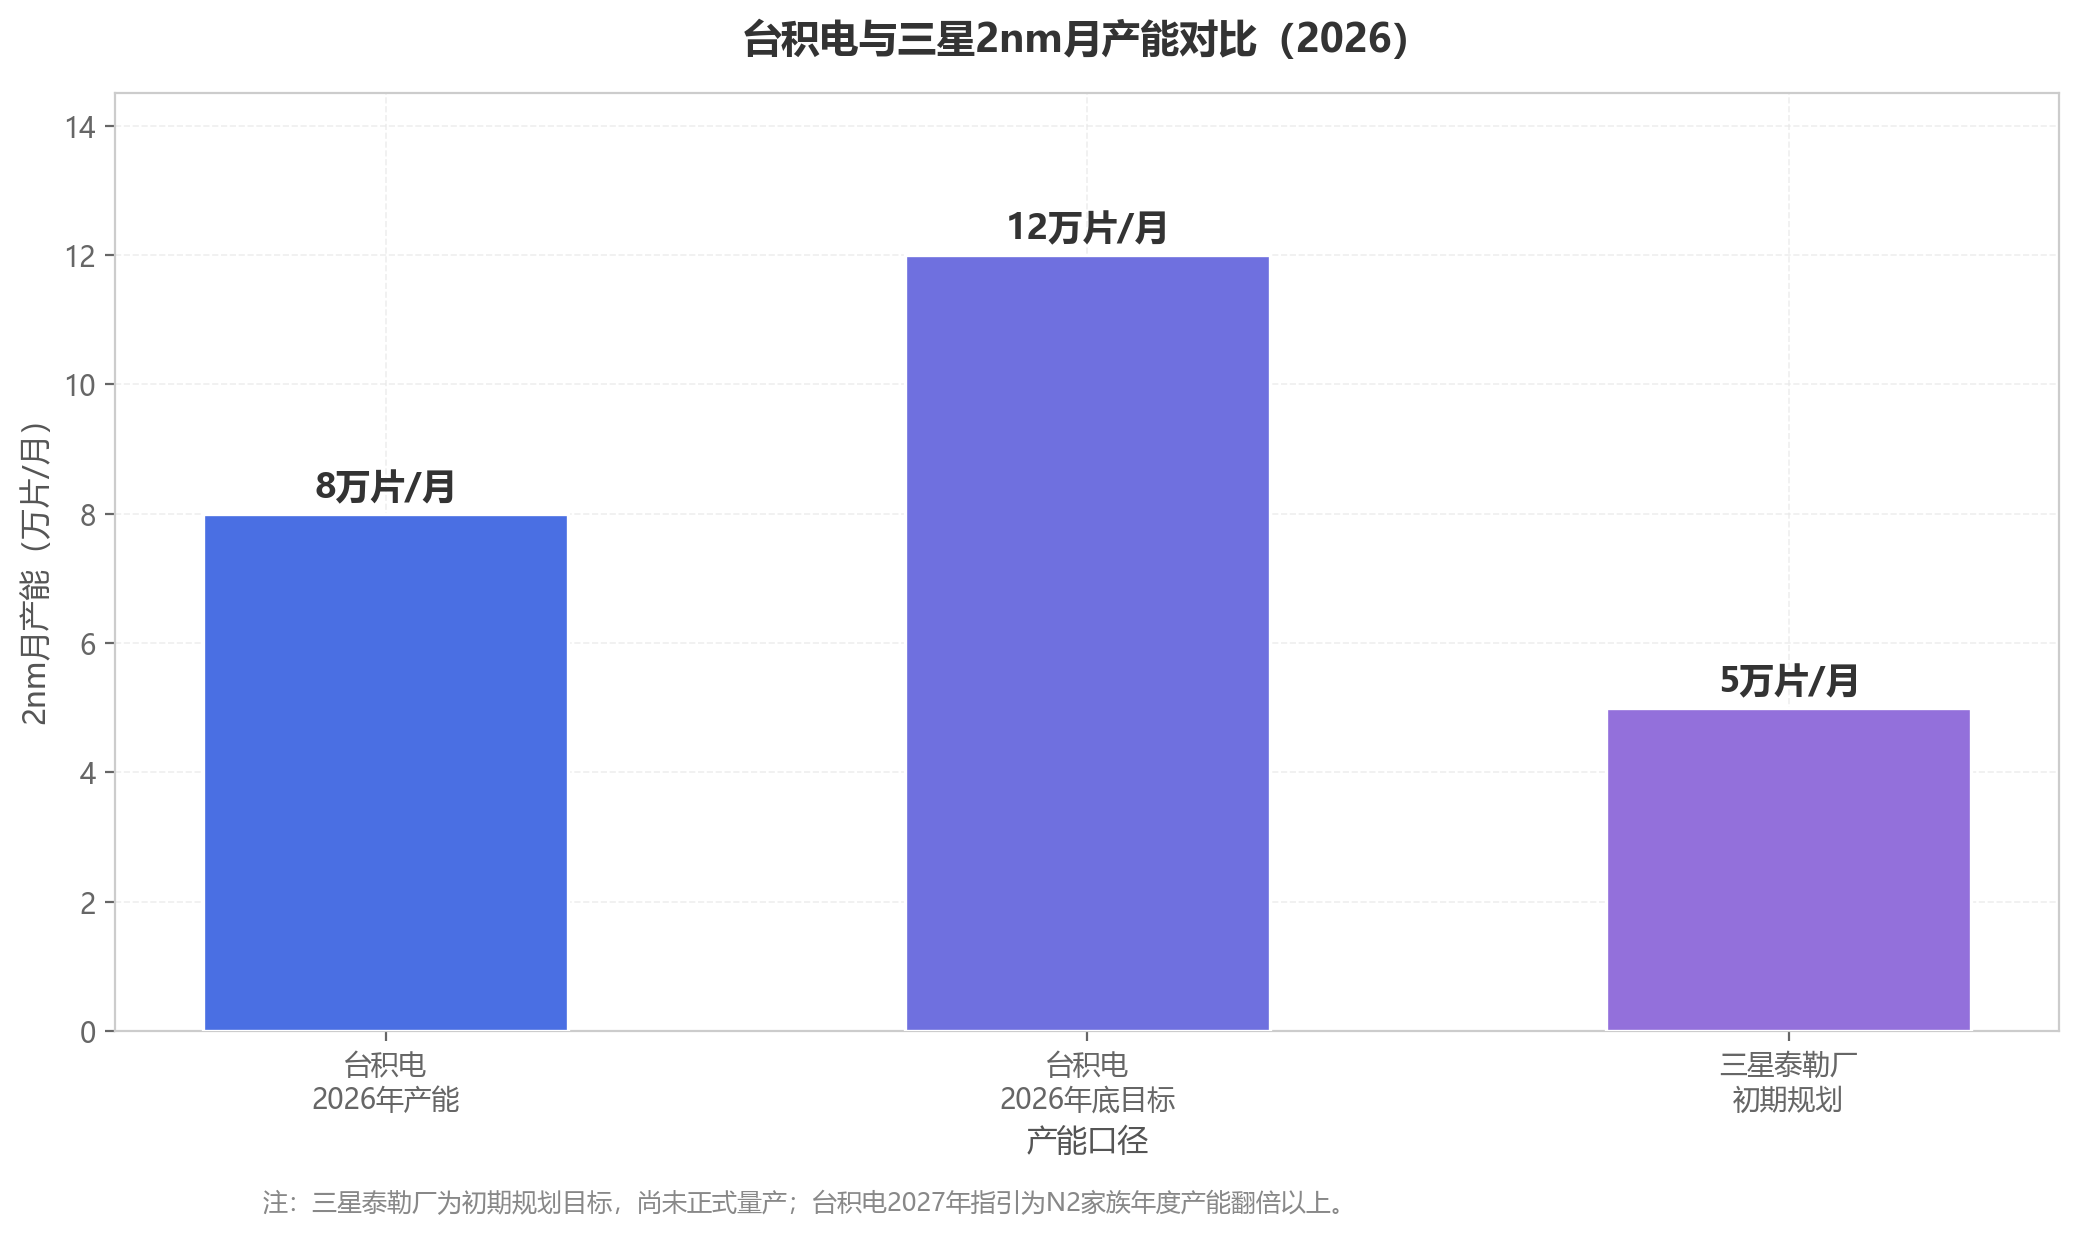
在这个背景下,5nm抢单与泰勒厂提速就都顺理成章了。代工是重资产生意,产线闲置一天就是一天的固定成本,提高成熟节点利用率是三星近期财务改善最直接的抓手。而泰勒厂,三星在美国的首座2nm晶圆厂,计划2026年下半年量产、初期月产能5万片,三星已把韩国本土最稀缺的良率工程师团队派往德州驻场。市场端的消息更为激进:泰勒厂尚未正式量产,规划产能已被预订一空。
客户名单:HPC改写了游戏规则
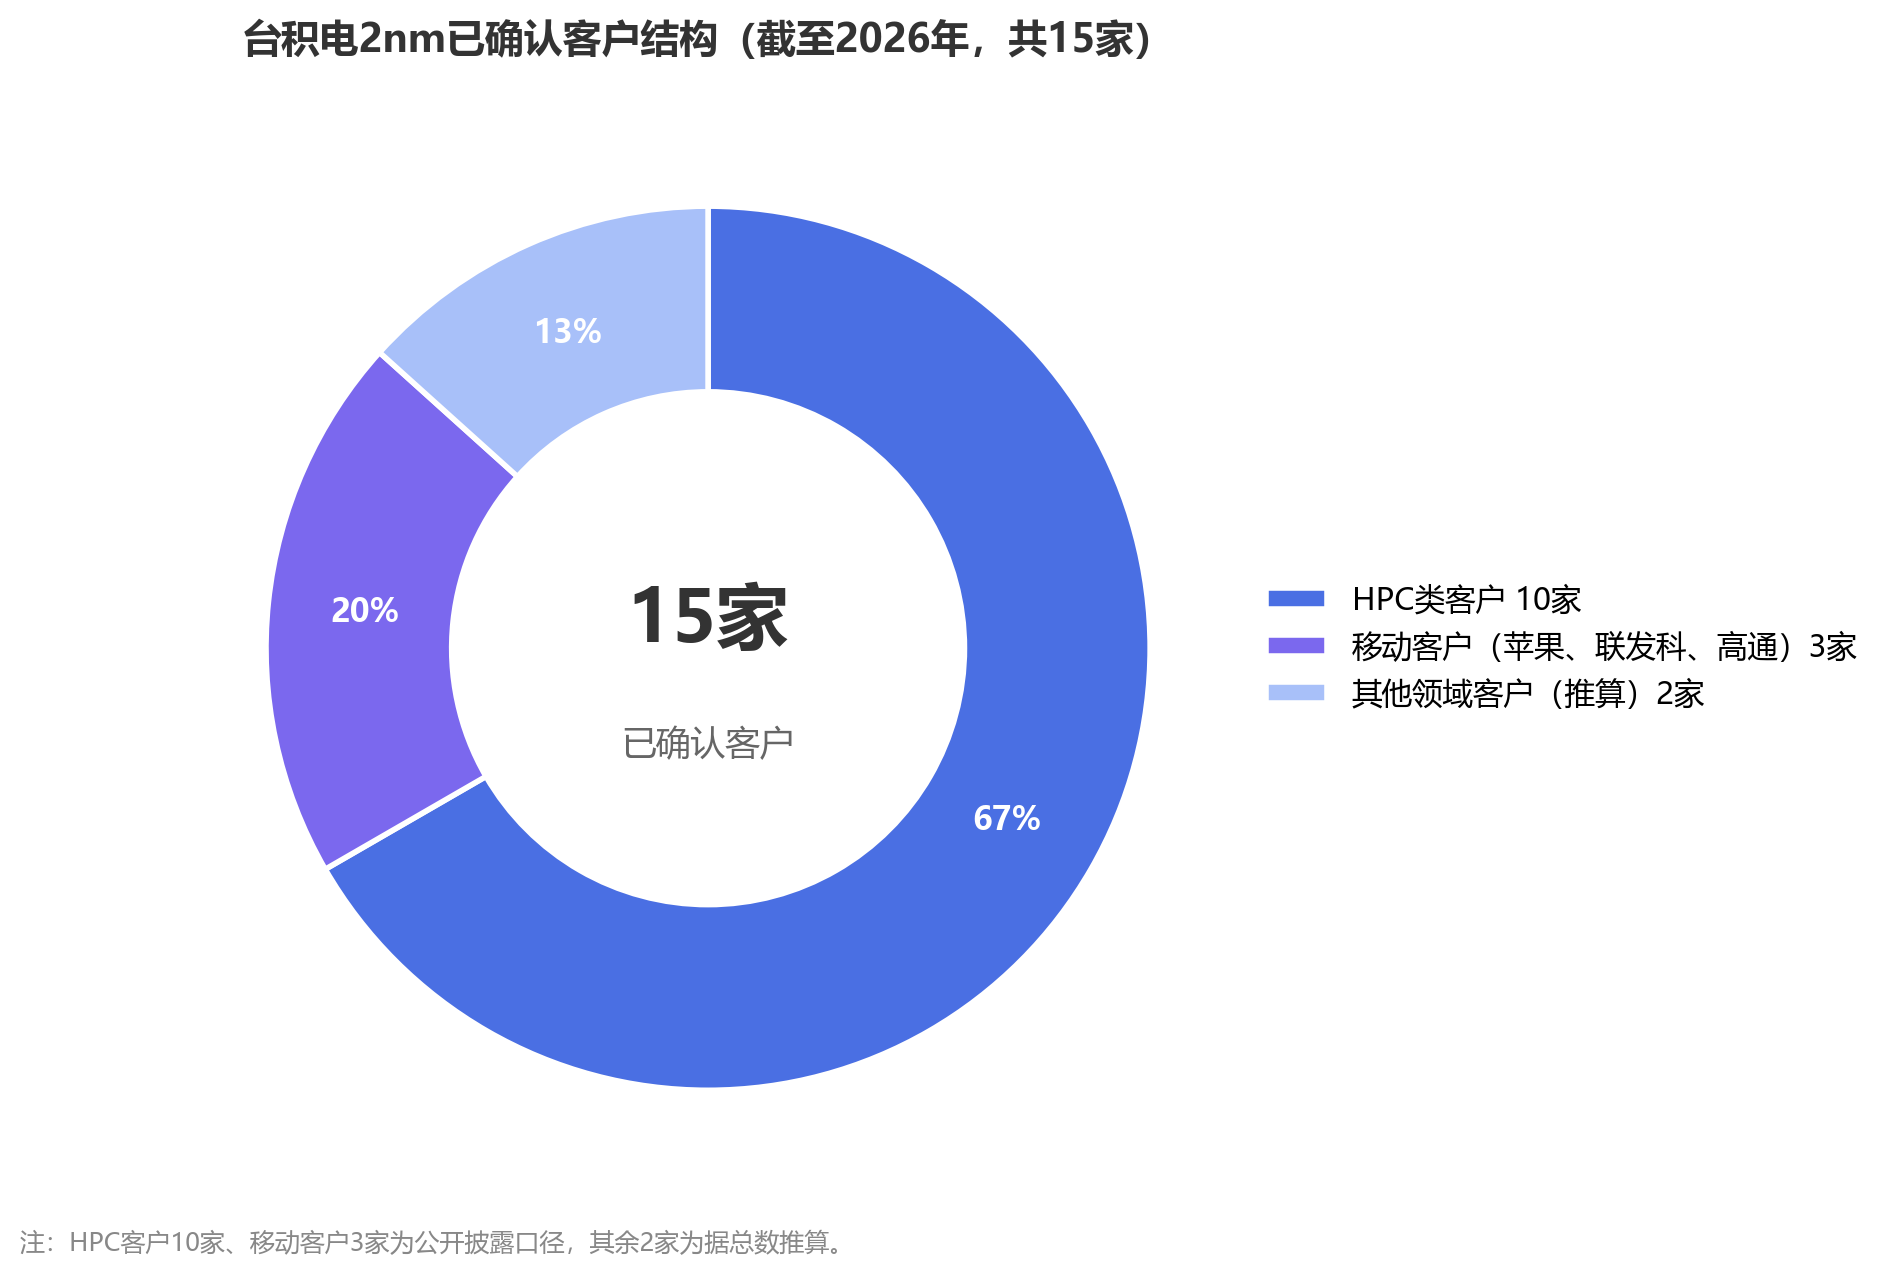
台积电2nm已确认的15家客户里,HPC客户占了10家,苹果、联发科、高通三家移动客户仍是主要采用者。这个结构值得细看:过去先进制程的第一波客户几乎都是手机芯片,而这一代,AI与高性能计算客户在数量上占了多数,2nm产能的分配权正在从手机转向数据中心。终端市场的信号同步落地:小米18 Pro全球首发高通骁龙2nm旗舰移动平台,OPPO Find X10 Pro Max首发联发科天玑9600 Pro,安卓阵营的2nm旗舰战已经开打。
三星的客户名单则是另一副牌。泰勒厂锁定了特斯拉AI5芯片的量产,博通的网络芯片与Arm的订单也传闻在列;高通被曝正在探索与三星2nm合作;韩媒Chosun Daily与SamMobile更传出英伟达、高通斟酌将部分2nm订单从台积电分流至三星的消息,驱动因素正是产能与成本。在中国市场,三星正与比亚迪等整车厂就2nm、4nm车用SoC展开洽谈,而蔚来已在三星5nm上生产自动驾驶芯片。再加上2nm晶圆约2万美元、较台积电便宜约三分之一的报价,三星的打法清晰可见:不与台积电在正面战场拼产能,而是用价格、地缘与差异化场景,承接“台积电装不下”和“台积电太贵”的需求。
“谈判慢”的三种解释
三星2nm合同迟迟未定,到底是自己没准备好,还是客户在等台积电?
第一种解释指向三星自身的验证问题。客户在把前沿设计投入量产之前,必须评估良率、能效、知识产权兼容性与制造稳定性,先进制程的评估周期本就以年计;三星2nm良率至今未公开站上70%门槛,大规模量产记录为零,泰勒厂的量产时点也还在2026年下半年与2027年之间摇摆。对任何一个要押上数亿美元掩膜与设计成本的客户来说,把风险敞口压后,是教科书式的选择。
第二种解释指向客户的观望。台积电产能爆满,但爆满不等于不可等待,2027年产能翻倍以上的指引给等待标了价;4nm和5nm在性能与成本之间提供了中间选项,对AI推理芯片、ASIC等不需要极致制程的产品足够好用;而"英伟达、高通考虑把部分订单分给三星"的传闻本身,恰恰说明客户在经营双供应链,等待不是被动,而是议价。
第三种解释最少被谈论:三星在主动控制谈判节奏。报价下调三成、泰勒厂的地缘差异、车用芯片的差异化切入口,这些动作组合起来,是“用第二供应商身位换长期入场券”的打法。对三星而言,眼下最重要的不是抢下一份2nm合同,而是让代工事业先活过来:利用率回到100%、亏损收窄,比一份定价权缺失的旗舰订单更有战略价值。
三种解释并非互斥,权重却在随时间变化:良率未过门槛时,验证问题是主要矛盾;一旦良率站稳、泰勒厂首批流片落地,观望就会迅速转化为实际的订单分流,泰勒厂产能未产先满,已经是这场转化的预演。
时间差的尽头
这场时间差的本质,是两家公司用各自的方式为不确定性定价。台积电用当下的满产满销,锁定2027年之后的订单纵深;三星用4nm与5nm的现金流,为2nm的爬坡买时间,再用泰勒厂的地缘溢价和激进报价,为自己在客户的多供应链布局里预埋一个位置。
接下来值得盯住的信号有三个:三星2nm良率何时公开站上70%的量产门槛;泰勒厂能否兑现2026年底首批流片、2027年量产爬坡的承诺;以及高通、英伟达的2nm订单最终如何在两家之间分配。时间差不会永远存在,但当它收窄的那一刻,晶圆代工的定价权天平,才会真正开始第二次摆动。
4. 韩国10月前20天半导体出口额激增222.5%至275亿美元
韩国关税厅10月21日发布的“10月1–20日进出口动向(初值)”显示,10月前20日韩国出口额达616亿美元,同比增长105.4%(增加316.1亿美元),创同期历史新高;剔除工作日差异后的日均出口额为47.4亿美元,同比增长65.9%,同样创下有记录以来最高水平。
半导体继续成为拉动出口增长的主力。前20日半导体出口额达275亿美元,同比大增222.5%;半导体在整体出口中的占比扩大至44.7%,较去年同期提升16.2个百分点。计算机外设(+424.0%)、石油产品(+68.3%)、乘用车(+40.9%)出口亦同步增长。
分地区来看,韩国对中国大陆(+154.9%)、美国(+154.4%)、欧盟(+78.2%)、越南(+74.6%)、中国台湾(+36.7%)等主要市场的出口全线上扬,前三大出口目的地——中国大陆、美国、越南合计占总出口的52.7%。
同期进口额为471亿美元,同比增长42.8%(增加141.3亿美元),其中半导体(+78.4%)、原油(+42.9%)、天然气(+112.4%)等主要品类进口均有所增加。前20日贸易收支实现145亿美元顺差。
5. 英伟达斩获Modal订单,Vera CPU撬动数据中心算力格局
核心观点
观点一: Modal弃用纯x86方案转投Vera,标志英伟达CPU从自家平台配套走向对外承接订单。英伟达预计本财年Vera销售额至少200亿美元,AI推理正让CPU成为英伟达新的增长曲线。
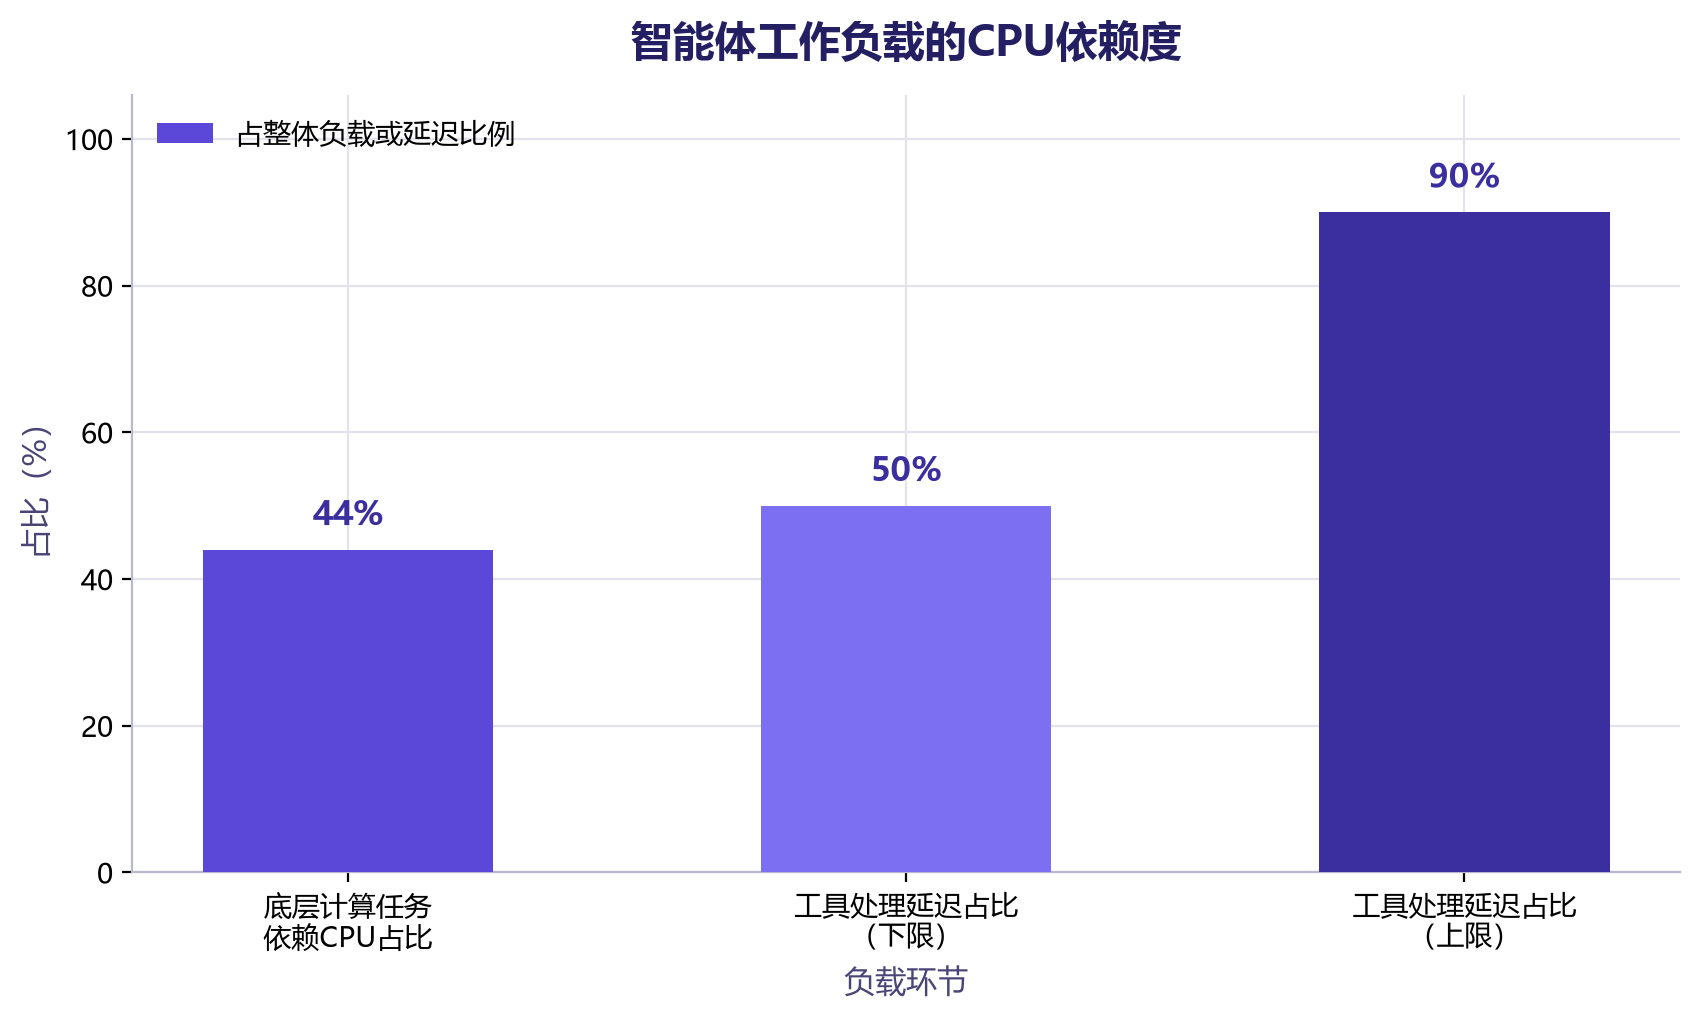
观点二: 智能体工作负载中,CPU工具处理环节占总延迟的50%至90%,约44%的底层计算任务依赖CPU。Vera专为智能体编排与工具调用优化,效率达传统CPU两倍,竞争逻辑正由通用性能转向场景优化。
观点三: AI服务器CPU与GPU配比正从1:8走向1:1,谷歌TPU、英伟达Vera、AMD EPYC等多元供给涌现,算力平台按推理场景精细定制,数据中心竞争进入多芯协同的系统性阶段。
据报道,AI初创公司Modal于周一宣布,将开始采用英伟达新一代Vera处理器运行人工智能推理负载,而此前其算力平台依赖英特尔和AMD的x86芯片。英伟达同期已告知投资者,预计本财年Vera芯片的销售额至少为200亿美元。这是继Anthropic、OpenAI、甲骨文云、SpaceX AI之后,又一家公开选择Vera的AI公司。
Vera加速商业落地
Vera的落地速度超出多数观察者预期。6月1日,黄仁勋在“GTC Taipei 2026”上首度公开这款专为代理式人工智能(Agentic AI)打造的CPU,宣告英伟达全面进军高效能运算。
参数层面,Vera搭载88个英伟达自研Olympus核心,兼容Armv9.2指令集,并在CPU层面原生支持FP8精度运算;借助空间多线程技术,它提供176个硬件线程,在物理层面对核心资源做硬分区,让每个线程在处理复杂逻辑分支时获得更稳定的尾部延迟表现。官方资料显示,Vera功耗450W,带宽高达1.8TB/s,为PCIe 6.0的7倍性能,被英伟达定位为新一代数据中心与代理AI的CPU首选。
在综合效能评比中,Vera较前代Arm架构Grace CPU提升约1.6倍(提升约60%);以Linux内核编译为例,单路Vera仅需20秒完成,每核效率约为128核x86芯片的两倍(较x86提升约100%);在7-Zip压缩测试中,单核能效较对照组x86处理器高约20%。
【图表:Vera处理器关键性能提升幅度】
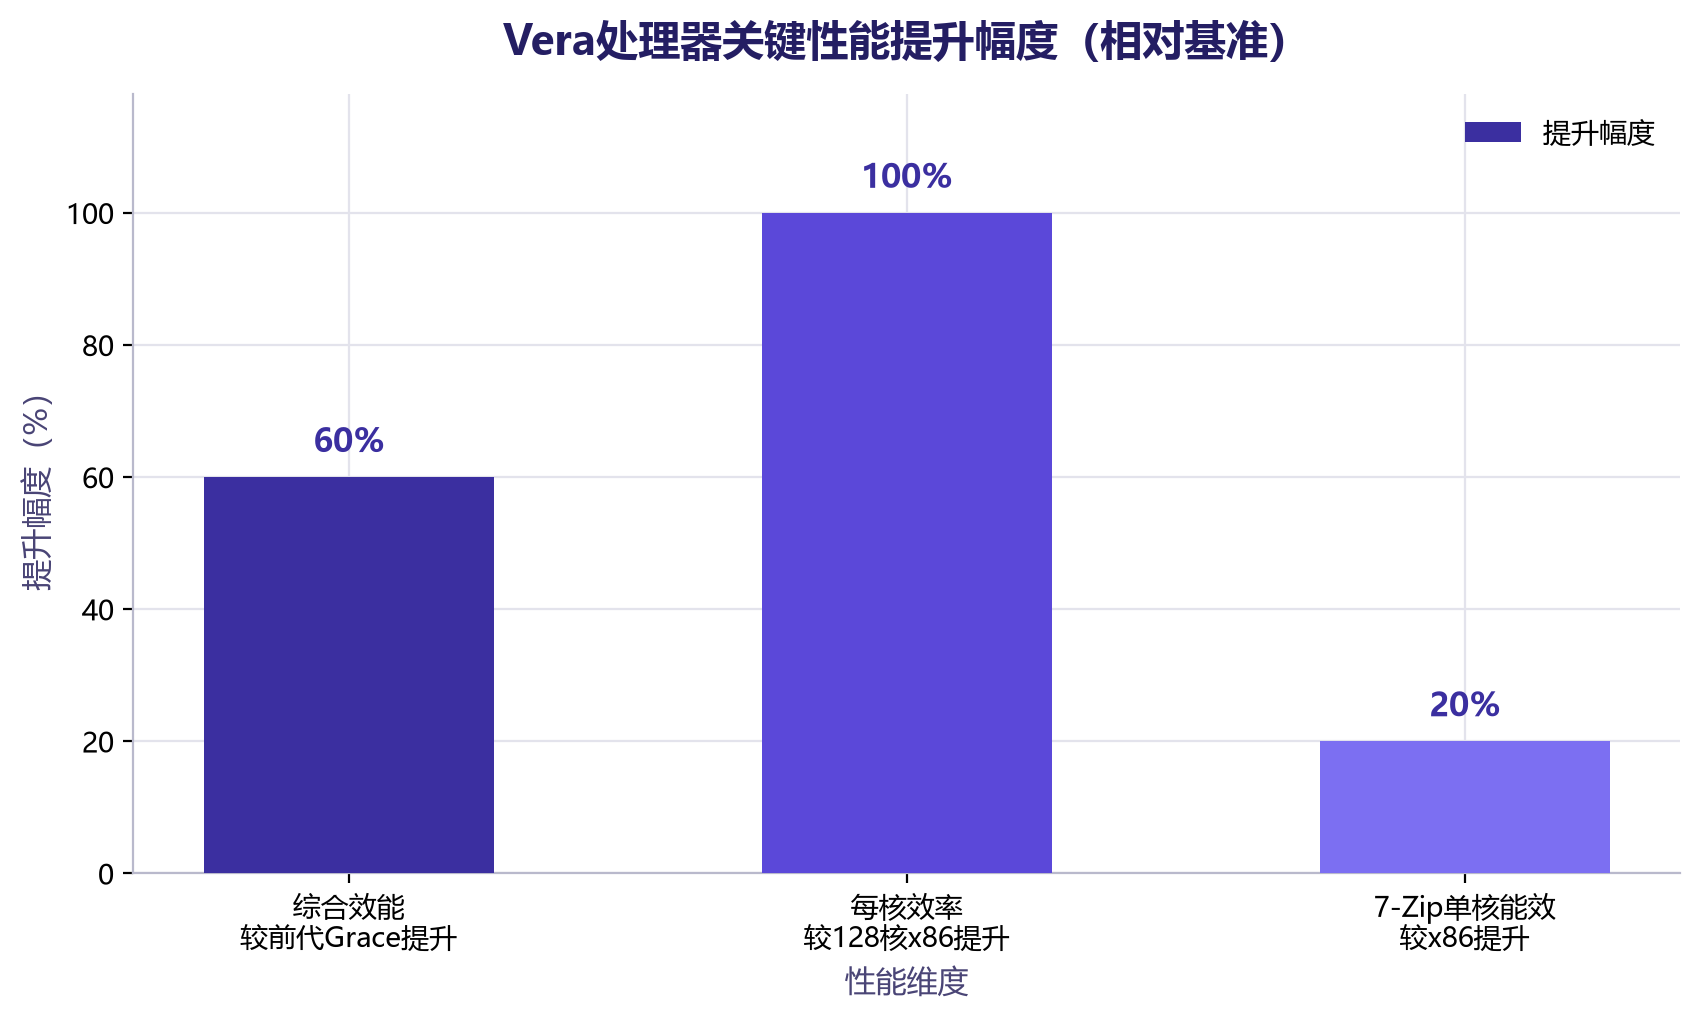
从图表可以看出,Vera的领先集中在新型CPU最被看重的维度:不是锦上添花的峰值主频,而是面向推理与智能体调度的真实效率。业内研究指出,在智能体工作负载中,CPU上的工具处理环节占总延迟的50%至90%,很多时候真正让用户等待的不是GPU,而是GPU在等待CPU完成工具调用、数据处理和任务安排。Vera正是针对这一痛点设计。
Vera落地节奏很快。据此前的报道,英伟达已将首批Vera CPU系统交付至Anthropic、OpenAI、甲骨文云与SpaceX AI等厂商当中。SK海力士也宣布围绕Vera CPU、Vera Rubin平台协同开发专用内存。如今Modal再次加入采用名单。黄仁勋将Vera定位为公司下一个数十亿美元级业务,并预测它将让英伟达进入一个规模约2000亿美元的CPU市场。
CPU竞争格局变化
长期以来,x86体系在桌面和服务器CPU市场占据主导地位,英特尔与AMD双寡头瓜分了几乎全部数据中心订单。Vera正对这一局面形成冲击,英伟达以Arm架构、自研核心的方式从GPU阵营反向切入CPU。
过去服务器CPU比拼的是通用性能:核心数量、主频与通用跑分。而在AI推理与智能体时代,客户要的是场景优化。汇丰证券研究指出,现代智能体工作流中约44%的底层计算任务高度依赖CPU,是传统文本生成模型的三到四倍;随着工作负载从训练转向推理再走向智能体,AI服务器的CPU与GPU配比正从1:8变为1:4,未来可能达到1:1甚至更高。AMD董事长兼CEO苏姿丰也公开承认,业界此前低估了CPU在AI时代的价值,她预计未来五年数据中心CPU市场年复合增长率将超过35%,远高于过去几年的个位数增速。
【图表:智能体工作负载的CPU依赖度】
面对英伟达的侧翼进攻,x86阵营的回应同样围绕场景展开。英特尔CEO陈立武表示基于Intel 3的至强6与基于Intel 18A的酷睿系列3产品已全面进入量产爬坡,公司最近一个季度营收136亿美元,同比增长7%,净利润同比暴增156%。2026年6月,AMD与英特尔CEO均在公开场合表示看好Agentic AI规模化应用对服务器CPU需求的拉动,并同步推出面向多智能体调度场景的CPU产品。
AI算力供给更加多元与精细化
Moda选用Vera,折射出AI算力供给的两个长期趋势。其一是多元化。苏姿丰判断,未来三到四年仅数据中心市场规模就可能超过1万亿美元,这个市场需要CPU、GPU、ASIC等多种技术并存。英伟达自己也通过增持云服务商CoreWeave的股权,推动其基础设施规模化部署CPU资源。尽管也有观点提示AI数据中心芯片市场增速阶段性放缓,但CPU环节的结构性紧缺与多元竞争仍在强化。
其二是精细化。随着AI推理进入规模化部署阶段,芯片优化正由单颗性能提升走向多芯协同和集群级效率优化,算力竞争已不局限于单点硬件性能,而是走向芯片架构、软件栈、推理框架、集群调度、模型适配效率和开发生态的系统性竞争;CPU、GPU、存储与网络的协同被视为释放AI算力价值的关键路径。系统层面创新同样在加速:2026年被业界视为超节点规模化商用元年,算力竞争从单一芯片性能比较,扩展为系统架构、高速互联、软件生态适配及能源效率的全方位博弈。
对用户而言,这意味着算力采购从“买最快的一颗芯片”变成“为场景匹配最合适的算力组合”;对产业而言,这意味着没有任何一家公司可以独享全部订单。